2x RTX 5060 Ti versus GB10: waarom 32 GB VRAM verliest van 128 GB unified memory
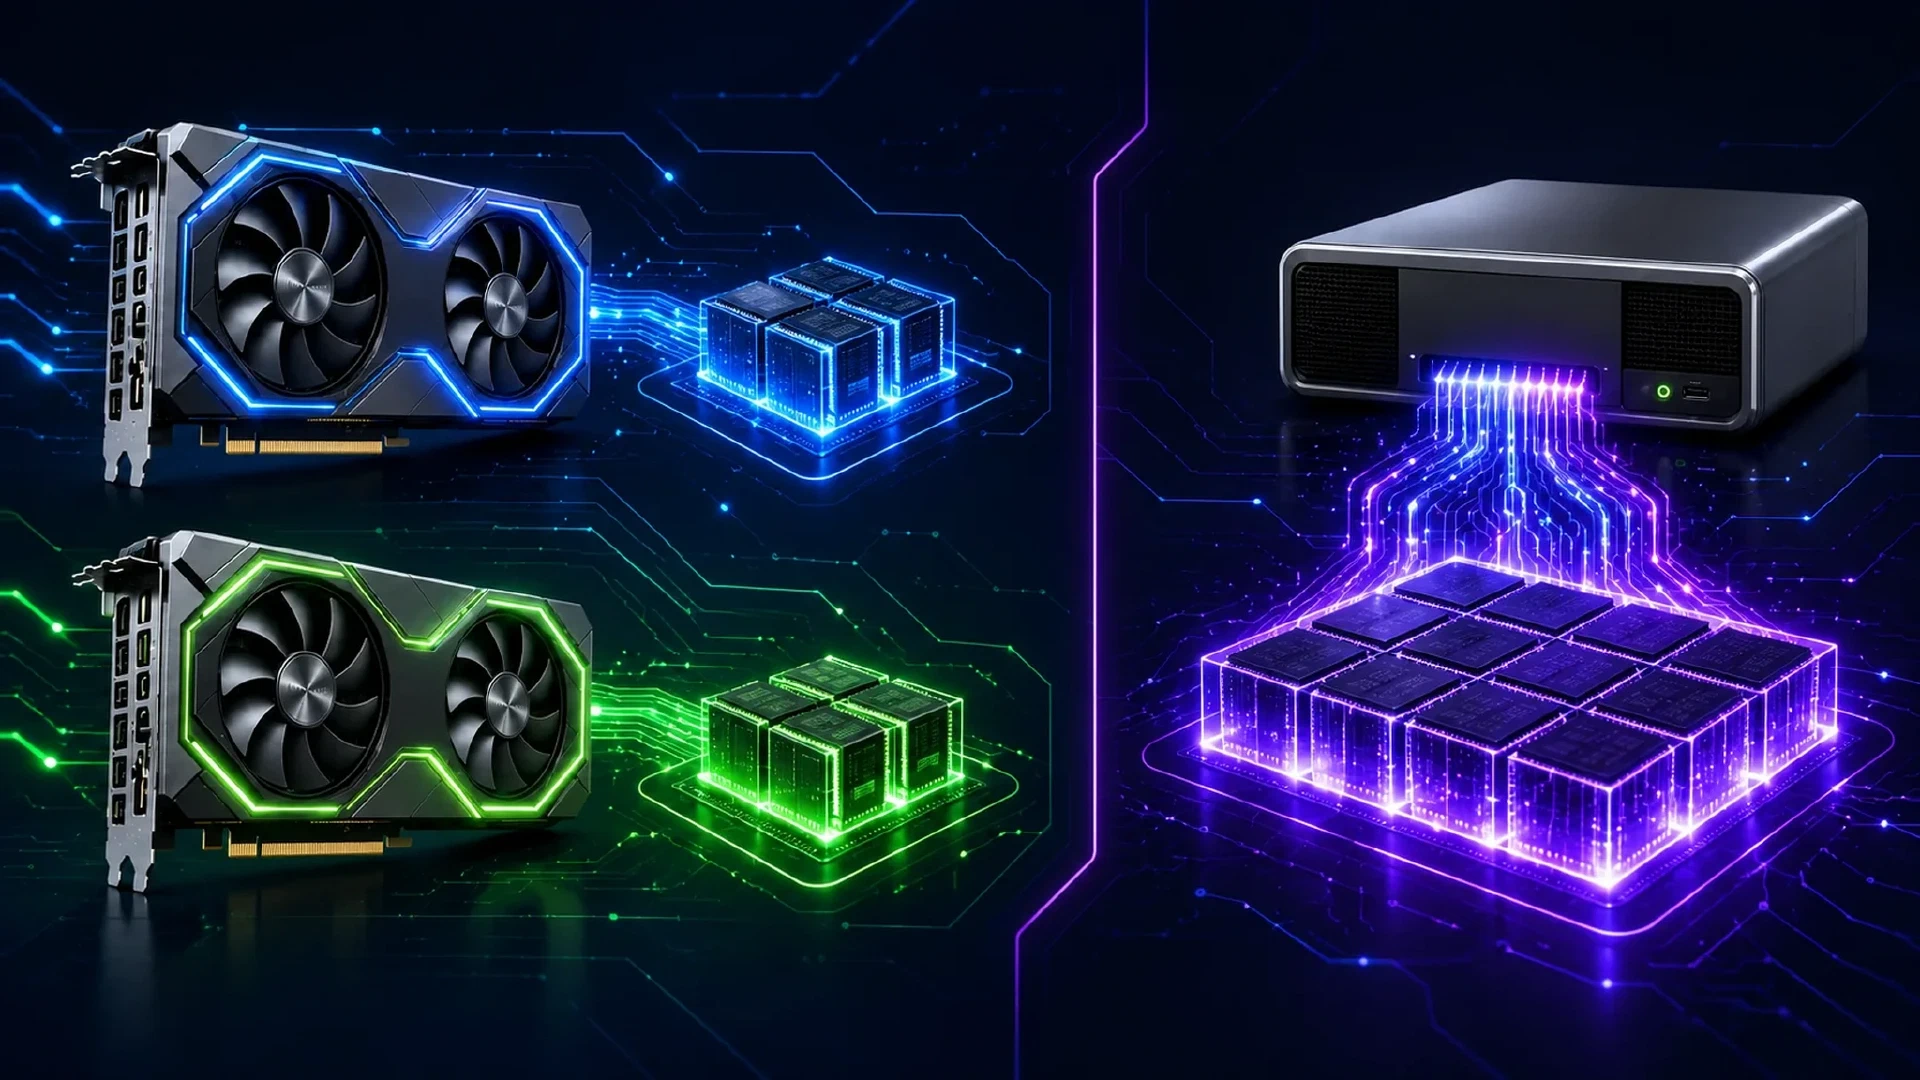
Table of Contents
Twee RTX 5060 Ti-kaarten van 16 GB lijken aantrekkelijk op een onderdelenlijst. Ze bieden samen 32 GB VRAM en sterke promptverwerking bij een korte context. De vergelijking verandert wanneer je een 27B-model met een lange context uitvoert.
Het NVIDIA GB10-systeem gebruikt 128 GB coherent unified memory. NVIDIA vermeldt voor het GB10-platform 128 GB LPDDR5x unified memory en een chip-TDP van 140 W. De RTX 5060 Ti gebruikt 16 GB GDDR7 per kaart, een 128-bits geheugeninterface en een totaal grafisch vermogen van 180 W. De specificaties van de NVIDIA RTX 5060 Ti en de specificaties van de NVIDIA GB10 maken het hardwareverschil duidelijk.
Het punt is eenvoudig. Twee kaarten van 16 GB maken geen snelle geheugenpool van 32 GB. Ze maken twee afzonderlijke pools van 16 GB die via het hostsysteem verbonden zijn. Bij inferentie van grote modellen tellen de ontbrekende capaciteit en dataverplaatsingen tussen apparaten zwaarder dan het aantal kaarten.
De geheugendeling
| Systeem | Geheugen | Geheugenmodel | Vermogenswaarde |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB totaal | Twee afzonderlijke GPU-geheugenpools | 360 W GPU totaal |
| GB10-systeem | 128 GB | Coherent unified system memory | 140 W GB10-TDP |
De GB10 wint niet omdat 128 GB LPDDR5x dezelfde bandbreedte biedt als een high-end discrete GPU. Het voordeel komt door capaciteit en plaatsing. CPU en GPU delen dezelfde adresruimte. Het model, runtimebuffers, activaties en contextdata hoeven daardoor niet in twee geïsoleerde apparaten van 16 GB te passen.
Het systeem met twee kaarten heeft een moeilijker plaatsingsprobleem. Het model moet over beide kaarten passen. De inferentieruntime moet data tussen beide kaarten verplaatsen. PCIe-verkeer verhoogt de latentie en verbruikt bandbreedte. De RTX 5060 Ti ondersteunt volgens de specificaties van NVIDIA ook geen NVLink.
Het benchmarkresultaat
De volgende resultaten komen uit het aangeleverde AI-benchmarkrapport. Het rapport vergelijkt een naamloos dual-GPU-systeem, aangeduid als 5060ti-x2, met een GB10-systeem. De test behandelt Qwen en GPT-OSS bij verschillende contextgroottes.
De modellen kwamen rechtstreeks uit Ollama. De test gebruikte de letterlijke standaardtags qwen3.8:27b en gpt-oss:latest, zonder aangepaste Modelfile of alternatieve quantisatie. Het 5060ti-x2-systeem gebruikte PCIe Gen4 x16 en de nieuwste beschikbare NVIDIA Linux-drivers toen de benchmark draaide.
Qwen-promptverwerking en generatie
| Context | 5060ti-x2 prompt tok/s | 5060ti-x2 generatie tok/s | GB10 prompt tok/s | GB10 generatie tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
Bij 4K genereert het systeem met twee kaarten ongeveer twee keer zo snel als de GB10. Bij 64K daalt de voorsprong naar ongeveer 1,5 keer. Bij 128K bereiken de systemen ongeveer dezelfde generatiesnelheid.
Bij 256K ziet de configuratie met twee kaarten er niet langer uit als de winnaar. Het 5060ti-x2-verzoek bereikte slechts 171.359 echte prompttokens. De generatie daalde naar 1,2 tokens per seconde. De GB10 voltooide de volledige 256K-test met 25,8 tokens per seconde.
De GB10 genereerde in het geteste 256K-resultaat ongeveer 21,5 keer sneller. Belangrijker is dat de GB10 de gevraagde context voltooide. Het systeem met twee kaarten leverde niet dezelfde workload.
Waarom geaggregeerde VRAM misleidt
1. Het model ziet geen enkele kaart van 32 GB
Twee GPU’s voegen hun geheugen niet samen tot één lokale adresruimte. Een model-parallel runtime verdeelt lagen of tensors over de apparaten. Elk apparaat heeft nog steeds ruimte nodig voor de toegewezen gewichten, tijdelijke buffers en een deel van de contextstatus.
De bruikbare capaciteit ligt daarom lager dan de eenvoudige som. De exacte overhead hangt af van het modelformaat, de quantisatie, de inferencebackend, de tensorsplitsing en de contextlengte.
2. Contextgeheugen groeit tijdens generatie
Modelgewichten vormen maar een deel van het geheugenbudget. De key-value-cache, of KV-cache, bewaart aandachtsdata voor eerdere tokens. Langere contexten vereisen meer cachegeheugen. Een 4K-test voorspelt geen implementatie met 128K of 256K.
De aangeleverde resultaten tonen deze grens duidelijk. Het systeem met twee kaarten houdt een sterke voorsprong bij promptverwerking, maar verliest generatiesnelheid wanneer de context groeit. De GB10 blijft van 4K tot 256K rond 26 tot 29 gegenereerde tokens per seconde.
3. PCIe-transfers voegen kosten toe
Wanneer de runtime activaties of tensors tussen GPU’s verplaatst, loopt de transfer via de hostinterconnect. Dit creëert synchronisatiepunten en voegt latentie toe aan elke stap. De straf wordt groter wanneer de workload herhaaldelijk de apparaatgrens overschrijdt.
Dit maakt een dual-GPU-systeem niet onbruikbaar. Geheugenplaatsing maakt deel uit van het prestatieresultaat. Een benchmark die alleen promptverwerking bij 4K rapporteert, mist deze kosten.
4. Energie-efficiëntie is een voordeel van het hele systeem
De GB10 gebruikt in deze vergelijking minder energie en biedt meer geheugencapaciteit voor de geteste workload met lange context. Twee RTX 5060 Ti-kaarten hebben samen een GPU-vermogenswaarde van 360 W voordat de rest van het systeem meetelt. NVIDIA vermeldt een GB10-TDP van 140 W.
De GB10 ruilt pieksnelheid bij korte context in voor capaciteit, voltooiing en lager GPU-vermogen. Voor Qwen-inferentie met lange context tellen deze afwegingen.
Het 5060ti-x2-systeem kost veel minder
De prestatievergelijking wist het prijsverschil niet uit. Een compleet werkstation met twee RTX 5060 Ti-kaarten van 16 GB stond op 10 oktober 2026 vermeld voor $3.479. De configuratie bevat een Intel Ultra 7 265K, Z890-moederbord, 32 GB DDR5, 1 TB opslag, een voeding van 1.000 W en beide GPU’s. Bekijk de complete dual-GPU-werkstationvermelding .
De Amerikaanse marketplace van NVIDIA vermeldt de 128 GB DGX Spark voor $6.950. De vermelding bevat 128 GB coherent unified memory en 4 TB NVMe-opslag, maar toont het systeem als niet op voorraad. Bekijk de huidige NVIDIA DGX Spark-vermelding .
Het AMD Ryzen AI Halo Developer Platform is een ander vergelijkingspunt. Dit Strix Halo-systeem kost bij Micro Center $3.999,99 en biedt 128 GB LPDDR5x unified memory en 2 TB opslag. Strix Halo valt vaak in dezelfde praktische lokale-AI-klasse als GB10-systemen, hoewel onafhankelijke tests GB10 vaak voor meten op het gebied van throughput en softwarevolwassenheid. Bekijk de huidige Micro Center Linux-vermelding en lees de review van Strix Halo versus GB10 .
| Compleet systeem | Vermelde prijs op 10 oktober 2026 | Prijsverschil |
|---|---|---|
| 5060ti-x2-werkstation | $3,479 | Basis |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 meer |
| 128 GB GB10 DGX Spark | $6,950 | $3,471 meer |
De GB10 biedt een grotere unified memory-pool, lager energiegebruik en een betere architectuur voor lange contexten. Het AMD-systeem biedt dezelfde 128 GB-geheugenklasse voor ongeveer $4.000. Het 5060ti-x2-werkstation blijft ongeveer 50% van de vermelde GB10-prijs, vóór belasting en verzending. Kopers die unified memory nodig hebben maar de softwarestack van NVIDIA niet nodig hebben, krijgen met Strix Halo een goedkoper alternatief.
Dit zijn vermelde prijzen van verschillende verkopers, geen gecontroleerde retailmand. De vergelijking laat het 5060ti-x2-systeem ook achter met minder systeemgeheugen en opslag. Het prijsverschil telt nog steeds omdat beide vermeldingen complete, bruikbare computers beschrijven en geen losse GPU-prijzen. Huidige RTX 5060 Ti-kaarten van 16 GB staan rond $789 tot $830 per stuk, ver boven de lancerings-MSRP van $429. Het prijsvoordeel van twee kaarten blijft daardoor bestaan tijdens de huidige GPU-prijsstijging. Bekijk de huidige RTX 5060 Ti-prijzen .
Het GPT-OSS-resultaat vraagt een aparte behandeling
Hetzelfde rapport toont sterke 5060ti-x2-generatieresultaten voor GPT-OSS van 4K tot 256K. De GB10 voltooit de tests van 4K tot 128K, maar de GPT-OSS-test van 256K staat als niet ondersteund vermeld.
Gebruik de GPT-OSS-tabel niet om een universele winnaar aan te wijzen. De tests bestrijken bij 256K niet hetzelfde bereik. Het Qwen-resultaat geeft een zuiverdere vergelijking voor lange context, omdat beide systemen een 256K-resultaat rapporteren, hoewel de 5060ti-x2-run slechts 171.359 echte prompttokens bereikte.
Wat dit betekent voor een Qwen 3 27B-build
Een configuratie met twee kaarten van 16 GB kan een gequantiseerd 27B-model bij een kleinere context draaien. De benchmark spreekt zo’n gebruik niet tegen. De data spreken de claim tegen dat 32 GB geaggregeerde VRAM dezelfde praktische ruimte biedt als een systeem met 128 GB unified memory.
Dat een model op een kaart past, bewijst alleen de capaciteit voor de gewichten. De echte geheugenbehoefte bestaat uit modelgewichten, actieve context, KV-cache, runtimebuffers en ruimte voor het besturingssysteem. De context moet naast het model passen. Een model dat laadt maar geen ruimte overlaat voor het werkgesprek is geen bruikbare configuratie voor lange context.
Dit sluit aan bij de dimensioneringsrichtlijnen in Is 16GB VRAM Enough for Serious Local LLM Work? , die gewichten, context en runtimeallocaties als één budget behandelen. De 32GB VRAM guide for Qwen 27B trekt dezelfde conclusie voor configuraties met twee kaarten. Geaggregeerde capaciteit is niet hetzelfde als bruikbare ruimte.
Stel vóór aankoop van hardware voor Qwen 3 27B vier vragen:
- Past de gevraagde quantisatie met de runtimebuffers? Alleen modelgewichten bepalen de geheugenbehoefte niet.
- Past de context zonder zware druk op de KV-cache? Lange prompts veranderen het resultaat.
- Gebruikt de runtime een snelle verdeling over apparaten? PCIe-transfers en tensorplaatsing beïnvloeden elke gegenereerde token.
- Voltooit het systeem de doelcontext? Een snel 4K-resultaat compenseert geen mislukte 256K-workload.
De aangeleverde test beantwoordt de laatste vraag voor het systeem met twee kaarten. De run bereikte 171.359 tokens tijdens het Qwen-verzoek van 256K en genereerde met 1,2 tokens per seconde. De GB10 voltooide 256K met 25,8 tokens per seconde.
Voor deze workload met lange context is unified memory de betere architectuur wanneer het alternatief PCIe gebruikt om de werkset van het model te spreiden. PCIe blijft een capaciteitsoplossing. PCIe maakt niet dezelfde geheugenpool, latentie of transferroute. De local AI GPU context guide legt uit waarom modelgewichten, KV-cache, tooloutput en runtimebuffers samen moeten worden gedimensioneerd. De Ollama Qwen3.8 27B GPU benchmark toont ook waarom resultaten met lange context apart moeten worden bekeken van decodecijfers met korte context.
Oordeel
Twee RTX 5060 Ti-kaarten van 16 GB zijn een slechte vervanger voor een GB10 wanneer het doel 27B-inferentie met lange context is. Ze leveren hogere promptthroughput bij korte contextgroottes. Ze gebruiken ook meer GPU-vermogen en stellen de runtime bloot aan een gesplitste geheugenindeling.
De GB10 is in de aangeleverde resultaten trager bij promptverwerking. Het systeem is energie-efficiënter, biedt vier keer zoveel geaggregeerd geheugen en voltooit de volledige Qwen-test van 256K met bruikbare generatiesnelheid.
Als je korte prompts uitvoert en promptinname belangrijk vindt, heeft 5060ti-x2 een beperkte toepassing. Voor een 27B-model is de grotere unified memory-pool de betere keuze omdat model en context één coherente werkset delen. Unified memory blijft de voorkeur houden zodra PCIe-transfers in het inferentiepad komen.
De benchmark toont niet dat twee RTX 5060 Ti-kaarten Qwen 3 27B nooit starten. De data tonen waarom een model starten verschilt van de workload goed uitvoeren.
Beperkingen van de benchmark
Het aangeleverde rapport vermeldt de letterlijke Ollama-tags, maar registreert niet de opgeloste manifestdigests, modelrevisies, CPU, stroommetingen of koelconfiguratie. Het rapport vermeldt ook PCIe Gen4 x16 voor het 5060ti-x2-systeem en de actuele NVIDIA Linux-drivers tijdens de test. Behandel de cijfers als een waargenomen systeemvergelijking, niet als een universele ranglijst van elk RTX 5060 Ti-paar en elke GB10-implementatie.
De hardware-specificaties hierboven komen van NVIDIA. De prestatiecijfers komen uit de voor dit artikel aangeleverde benchmarkdata.
Referenties
- Ollama Qwen3.8-modellenbibliotheek
- Ollama GPT-OSS-modeltags
- Is 16GB VRAM Enough for Serious Local LLM Work?
- 32GB VRAM for Qwen 27B
- Local AI GPU Context Guide
- Qwen3.8 27B GPU Benchmarks on Vast.ai
- Complete dual RTX 5060 Ti 16 GB workstation listing
- NVIDIA DGX Spark US marketplace listing
- AMD Ryzen AI Halo 128 GB Linux listing
- Tom’s Hardware Strix Halo versus GB10 review
- RTX 5060 Ti current price checks
Related Posts