AI-cybersecuritycertificeringen: ze lopen achter op de praktijk

Table of Contents
We deden de examens. We slaagden. We kregen certificaten, maar hielden er een teleurstelling aan over die ik precies wil beschrijven.
Dit is geen klacht over de mensen die deze programma’s hebben gemaakt. Zij werken met onvolledig materiaal. AI-beveiliging is als vakgebied jong. Onderzoek naar aanvallen gaat sneller dan de verdedigingsmiddelen. De governancekaders verschenen voordat de technische richtlijnen er waren.
Het probleem is de kloof tussen wat de certificeringen onderwijzen en wat je moet weten om AI-systemen in productie echt te beveiligen.
Drie lagen die vaak door elkaar worden gehaald
Voordat we uitleggen wat ontbreekt, helpt het om de bestaande onderdelen uit elkaar te houden.
De eerste laag is governance. Documenten zoals NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 en de EU AI Act werken op organisatieniveau en procesniveau. Ze beschrijven hoe je AI-risico beheert, toezicht structureert en verantwoordelijkheid vastlegt. Ze richten zich bewust op governance in plaats van op voorgeschreven technische controles. Dat is opzet.
De tweede laag is de dreigingstaxonomie. MITRE ATLAS documenteert adversarial tactieken tegen AI-systemen in hetzelfde formaat als ATT&CK. De OWASP Top 10 for Large Language Model Applications somt de aanvalsklassen op die het relevantst zijn voor geïmplementeerde LLM’s. Deze documenten benoemen de aanvallen en leggen uit hoe ze werken. Ze schrijven geen verdediging voor.
De derde laag bestaat uit technische richtlijnen. Hieronder vallen Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) en beveiligingsdocumentatie van leveranciers zoals Anthropic, OpenAI en Meta. Deze bronnen geven technische richtlijnen voor veilige implementatie, evaluatiemethoden en runtimecontroles.
De meeste AI-governancecertificeringen behandelen de eerste laag grondig. De tweede laag komt op hoofdlijnen aan bod. De derde laag behandelen ze zelden.
Wat certificeringen behandelen
De huidige certificeringen voor AI-governance en beveiliging, waaronder IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, ISO 42001-certificeringen en CompTIA AI+, behandelen vergelijkbare onderwerpen.
Je leert het NIST AI RMF en hoe je de vier functies, Govern, Map, Measure en Manage, koppelt aan de AI-implementatie van je organisatie. Je leert de risicocategorieën van de EU AI Act en hoe conformiteitsbeoordeling voor systemen met hoog risico werkt. Je leert over bias, eerlijkheid, transparantie en verantwoordingsplicht als governanceprincipes. Je leert AI-governancebeleid opstellen en effectbeoordelingen uitvoeren.
Dit zijn echte vaardigheden. Organisaties hebben mensen nodig die governancekaders begrijpen en het NIST AI RMF lezen om te weten wat het document van hen vraagt.
Wat certificeringen niet met dezelfde diepgang onderwijzen:
- Hoe aanvallers AI-systemen in productie momenteel compromitteren
- Hoe defense-in-depth tegen prompt injection er operationeel uitziet en waarom geen enkele controle dit volledig voorkomt
- Hoe je de integriteit van modellen vóór implementatie verifieert
- Wat AI-red teaming inhoudt en hoe je de scope bepaalt
- Hoe je vóór de lancering modelgedrag tegen adversarial invoer beoordeelt
- Hoe AI-observability tijdens inferentie eruitziet
- Hoe AI-incidentrespons verschilt van standaard IR-draaiboeken
- Wat nodig is om AI-agenten met tooltoegang en externe integraties te beveiligen
Het NIST AI RMF gaat over governance, niet over engineering
Het NIST AI RMF is een goed opgebouwd document. NIST ontwierp het als technologieneutraal, sectoronafhankelijk en toepasbaar op verschillende benaderingen voor AI-ontwikkeling. Daardoor is het kader breed toepasbaar.
Het betekent ook dat het geen technische controles voor specifieke aanvalsklassen voorschrijft. Als je organisatie het AI RMF volledig toepast en alle functies koppelt aan de AI-implementatie, heb je gedocumenteerde risicoprocessen. Dat betekent niet automatisch dat je een verdediging hebt tegen prompt injection op je geïmplementeerde taalmodel.
NIST erkent dit. NIST AI 600-1, Generative AI Profile, verschenen in 2024, breidt het AI RMF specifiek uit voor generatieve AI en grote taalmodellen. Het behandelt risico’s als prompt injection, datavergiftiging en informatiegevaren op een detailniveau dat het basis-AI RMF niet haalt. Als je certificering het basis-AI RMF behandelde zonder AI 600-1, heb je het document gemist dat het relevantst is voor de systemen die nu in gebruik zijn.
ISO 42001 en de vergelijking met managementsystemen
ISO 42001:2023 is een norm voor AI-managementsystemen. De norm biedt een structuur voor het beheer van AI-ontwikkeling en -implementatie op organisatieniveau. Beveiligingsprofessionals herkennen de parallel met ISO 27001 voor informatiebeveiliging.
ISO 27001 wordt veel gebruikt. Gecertificeerde organisaties worden nog steeds gehackt. Een certificering documenteert dat een managementsysteem bestaat, een vast proces volgt en wordt beoordeeld. Ze certificeert niet dat de systemen onder dat proces bestand zijn tegen aanvallen.
ISO 42001 brengt organisatorische discipline. De certificering laat belanghebbenden zien dat AI-processen zijn vastgelegd, beoordeeld en onder governance vallen. Ze bewijst niet dat geïmplementeerde modellen onder adversarial omstandigheden consistente uitkomsten geven, dat agenten binnen vastgestelde vertrouwensgrenzen werken of dat fine-tuned modellen zijn gebouwd met gecontroleerde trainingsgegevens.
Dit is dezelfde kloof als bij ISO 27001. In de traditionele cybersecurity hebben we ermee leren werken. We moeten niet doen alsof AI-governancecertificeringen die kloof dichten wanneer ze dezelfde structurele beperking hebben.
De EU AI Act stelt resultaatvereisten, geen technische specificaties
De EU AI Act deelt AI-systemen in naar risiconiveau: onaanvaardbaar (verboden), hoog (conformiteitsbeoordeling verplicht), beperkt (transparantieverplichtingen) en minimaal (geen specifieke vereisten).
Systemen met hoog risico, waaronder systemen voor kritieke infrastructuur, biometrische identificatie, personeelsselectie, onderwijs en wetshandhaving, moeten voldoen aan vereisten voor technische documentatie, menselijk toezicht en robuustheid. De wet vereist expliciet dat zulke AI-systemen bestand zijn tegen pogingen om hun gedrag via adversarial manipulatie te veranderen.
Die eis staat in de wetstekst. De wet schrijft bewust resultaten voor in plaats van technische controles. Er is nog geen overeenstemming over technische methoden om adversarial robuustheid aan te tonen in alle implementatiecontexten, systeemtypen en gebruikssituaties.
Certificeringen rond de EU AI Act bereiden je voor op de classificatie van AI-systemen, technische documentatie en toezichtprotocollen. Ze bereiden je voor op audits. Het technische werk om een systeem te bouwen dat aan de robuustheidseisen voldoet, hoort bij een ander vakgebied dan de certificeringen momenteel behandelen.
Wat AI-systemen daadwerkelijk aanvalt
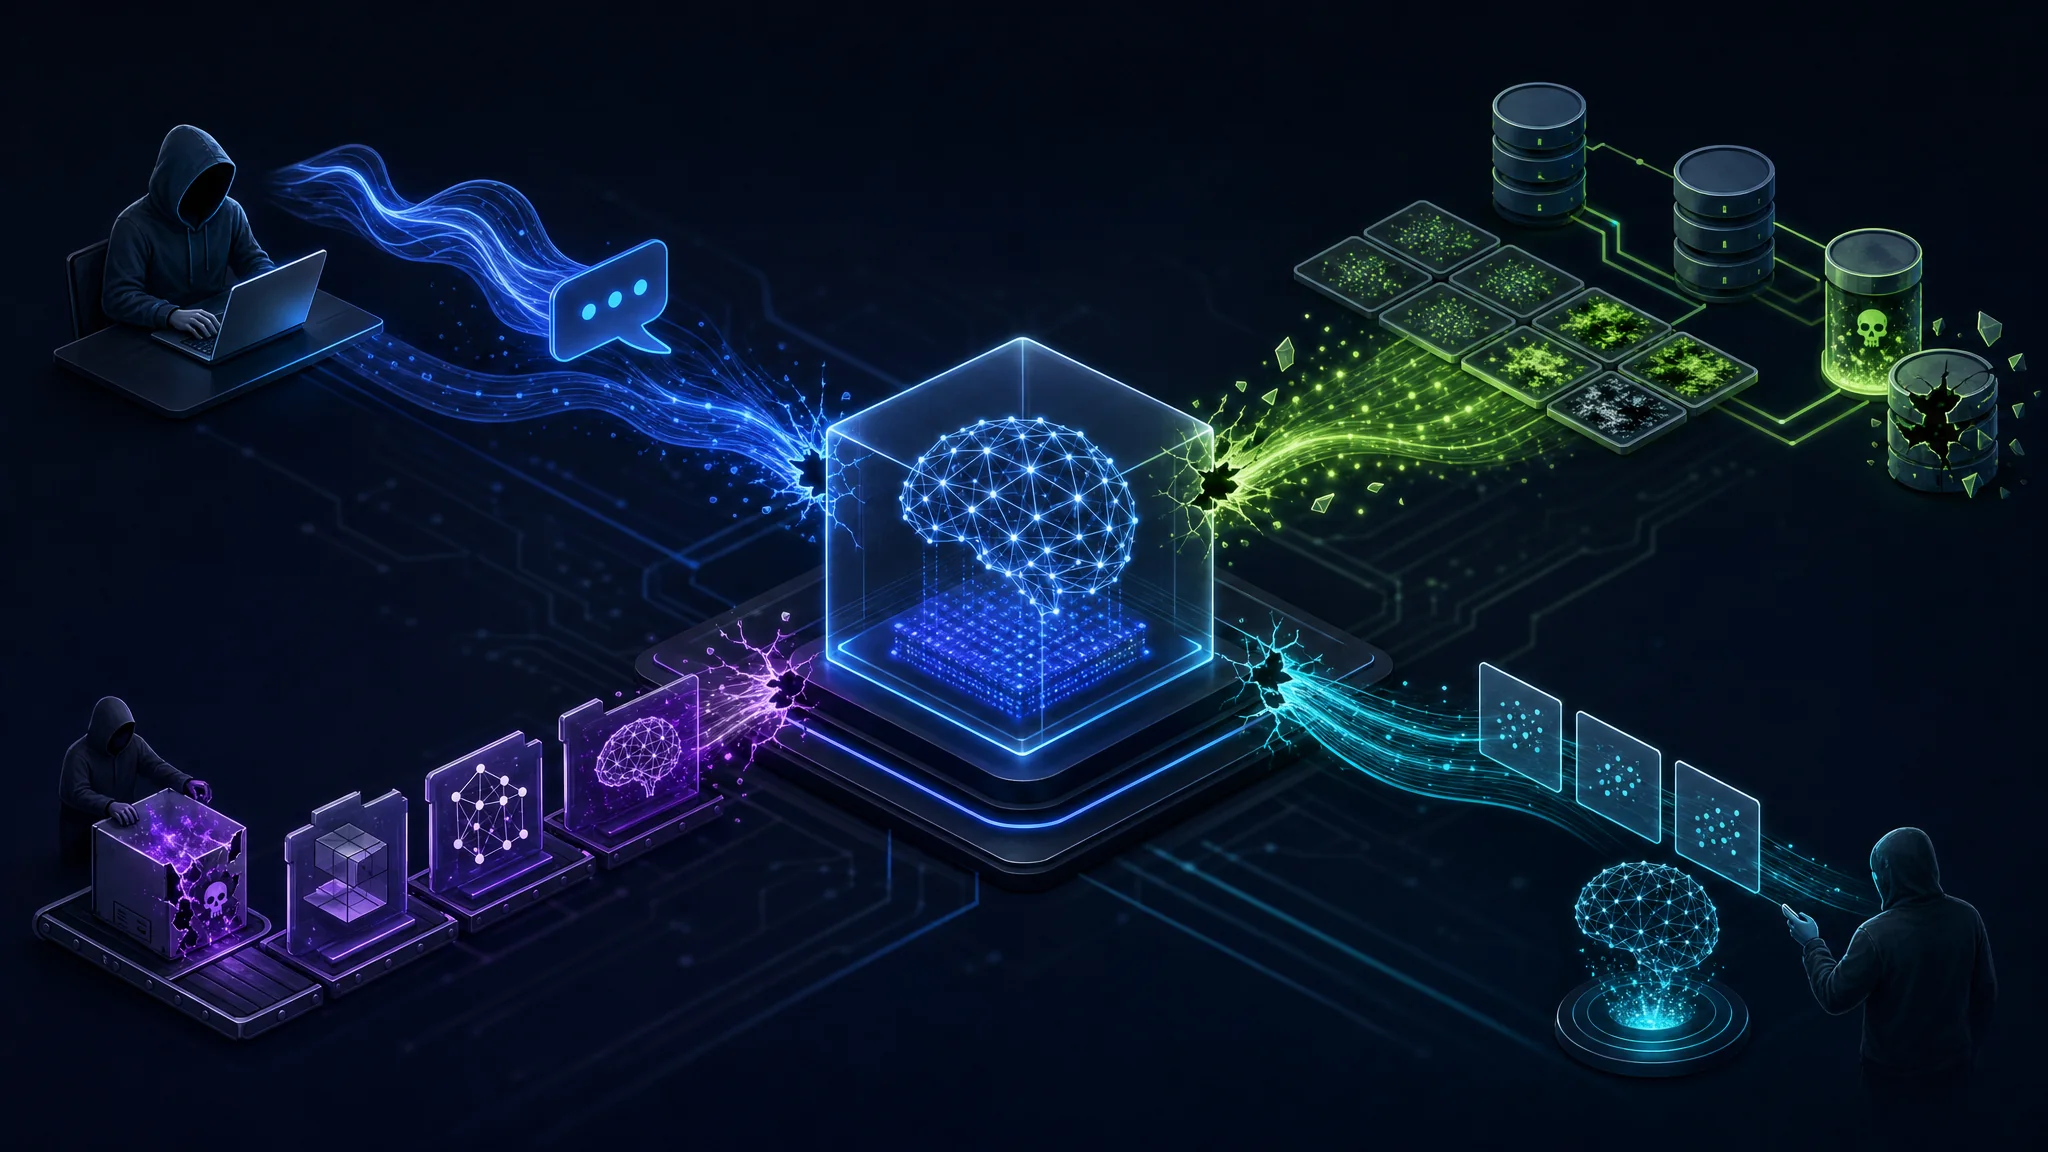
MITRE ATLAS en OWASP LLM Top 10 documenteren het operationele dreigingslandschap. Deze bronnen sommen aanvallen op met bruikbare details. Governancekaders beschrijven dreigingen abstracter. De volgende informatie komt uit deze specifieke beveiligingsbronnen.
Prompt injection werkt door invoer aan een taalmodel te geven die systeeminstructies overschrijft of manipuleert. Directe injection richt zich rechtstreeks op de invoer van het model. Indirecte injection verstopt kwaadaardige instructies in inhoud die het model ophaalt, verwerkt of samenvat. Je RAG-pipeline leest een document dat door een aanvaller wordt beheerd en voert verborgen opdrachten uit. Je browseragent bezoekt een pagina van een aanvaller en volgt de ingebedde aanwijzingen. Je klantenservicebot vat een ondersteuningsartikel samen met de opdracht om veiligheidsrichtlijnen te negeren.
In 2026 bestaat er geen universeel effectieve maatregel tegen prompt injection. Defense-in-depth verlaagt het risico met invoerfiltering, uitvoervalidatie, beperkte toolrechten, afgeschermde uitvoeromgevingen en menselijke goedkeuring voor belangrijke acties. Geen van deze maatregelen elimineert de aanvalsklasse. NIST, OWASP, Anthropic, OpenAI, Google en Microsoft adviseren gelaagde controles in plaats van één oplossing.
Datavergiftiging voegt kwaadaardige voorbeelden toe aan trainingsgegevens om modelgedrag te verslechteren, backdoors te introduceren of triggergedrag in te bouwen. Vaak ontbreekt een signaal van succesvolle vergiftiging totdat het model specifieke triggerinvoer tegenkomt. Als je organisatie modellen fine-tunet met gebruikersinhoud, opgehaalde documenten of datasets van derden zonder de herkomst te controleren, loop je dit risico.
Compromittering van de modeltoeleveringsketen is een dreiging die veel organisaties als bijzaak behandelen. Modelrepositories verspreiden vaak uitvoerbare code samen met modelgewichten. Onveilige serialisatieformaten zoals pickle hebben herhaaldelijk risico’s in de toeleveringsketen veroorzaakt. Pakketten bij modeldownloads kunnen kwetsbare afhankelijkheden installeren. Veel organisaties lijken modellen uit openbare repositories aanzienlijk minder streng te controleren dan softwareafhankelijkheden. Het aanvalsoppervlak is vergelijkbaar met npm, maar de beveiligingscultuur rond modellen staat nog in de kinderschoenen.
Model extractie stelt aanvallers in staat om via herhaalde inferentievragen aan je API functioneel vergelijkbare modellen te reconstrueren. Dit leidt tot verlies van intellectueel eigendom en maakt offline studie van je model mogelijk om gerichtere aanvallen te ontwikkelen.
Membership inference stelt aanvallers in staat om met verschillende mate van zekerheid te bepalen of specifieke gegevens in de trainingsset stonden. Dit hangt af van de modelarchitectuur en trainingsmethode. Het levert privacyrisico’s op voor organisaties die met persoonsgegevens hebben getraind.
Adversarial invoer manipuleert modeluitvoer met zorgvuldig gemaakte verstoringen. De techniek is het meest onderzocht voor beeldclassificatie, maar geldt ook voor tekst, audio en multimodale systemen. Als je AI beslissingen neemt over fraudedetectie, kredietwaardigheid, medische beelden of fysieke toegang, moet je adversarial robuustheid als beveiligingseigenschap testen in plaats van alleen documenteren.
Dataverlies via AI-systemen verdient directe aandacht. RAG-pipelines kunnen documenten uit je kennisbank tonen aan gebruikers die geen toegang horen te hebben. Promptlekkage uit systeeminstructies onthult operationele details die vertrouwelijk moesten blijven. AI-implementaties voor meerdere tenants vereisen isolatie, iets wat traditionele application-security-engineers soms onderschatten. Dit zijn praktische risico’s die regelmatig in geïmplementeerde systemen voorkomen.
AI-agenten veranderen het aanvalsoppervlak volledig
De meeste AI-beveiligingscertificeringen zijn geschreven toen AI-systemen vooral chatbots en classificatiemodellen betekenden. In 2026 betekent enterprise-AI steeds vaker agenten.
Agenten verschillen op een operationeel belangrijk punt van chatbots: ze voeren acties uit. Een agent met tooltoegang tot je e-mail, interne databases, bestandssystemen, browser en code-uitvoering is geen chatbot met extra functies. Het is een autonoom proces met aanzienlijke toegang tot echte systemen dat werkt op basis van taalmodeluitvoer.
OWASP beheert nu een afzonderlijke Agentic AI Top 10, omdat het dreigingsmodel voor agenten voldoende verschilt van LLM-chattoepassingen om aparte documentatie te vereisen.
Prompt injection in een agentcontext veroorzaakt geen ongewenst tekstantwoord, maar een ongewenste actie. Een indirecte instructie in een opgehaald document kan de agent opdracht geven bestanden te verwijderen, gegevens weg te sluizen of e-mails te versturen. Het gevolg is geen ongepast antwoord, maar een niet-geautoriseerde handeling op systemen waartoe de agent toegang heeft.
Het aanvalsoppervlak van agenten omvat:
- Beperkingen op toolaanroepen: is de agent beperkt tot de minimale tools die voor elke taak nodig zijn
- Reikwijdte van referenties: zijn de referenties van de agent beperkt tot wat elke taak vereist
- Omkeerbaarheid van acties: vereisen belangrijke acties menselijke goedkeuring vóór uitvoering
- Uitvoerfiltering: wordt uitvoer gevalideerd voordat die vervolgacties activeert
- Sandbox: voorkomt de uitvoeromgeving onbedoelde toegang tot verbonden systemen
De meeste AI-governancecertificeringen behandelen het beveiligingsontwerp van agenten niet op dit detailniveau.
Model Context Protocol creëert een nieuw enterprise-aanvalsoppervlak
Model Context Protocol (MCP) is een breed toegepaste standaard geworden om AI-agenten met externe tools, gegevensbronnen en diensten te verbinden. MCP-servers bieden mogelijkheden die agenten ontdekken en gebruiken. De integratie is snel en flexibel, maar de gevolgen voor beveiliging krijgen niet altijd evenveel aandacht.
MCP-specifieke risico’s zijn onder meer:
- Kwaadaardige MCP-servers die hun mogelijkheden verkeerd voorstellen en onbedoelde acties uitvoeren
- Toolvergiftiging, waarbij een legitieme MCP-server gegevens onder controle van een aanvaller teruggeeft en instructies in gegevensuitvoer verbergt
- Tools met te ruime rechten, waarbij MCP-integraties meer machtigingen hebben dan de taak vereist
- Verwarring over vertrouwensgrenzen, waarbij agenten instructies van gekoppelde MCP-tools behandelen alsof het gebruikersinstructies zijn
Organisaties die agenten met MCP-integraties inzetten, hebben een kader nodig om vertrouwen in MCP-servers te beoordelen, toolmachtigingen te controleren en te valideren dat toolreacties als gegevens en niet als instructies worden behandeld.
Evaluatie is de operationele praktijk die certificeringen overslaan
AI-red teaming en evaluatiesuites vervangen statische beveiligingsbeoordelingen als belangrijkste manieren om modelrisico vóór en na implementatie te begrijpen.
AI-red teaming omvat:
- Gestructureerde adversarial tests van modelgedrag tegen bekende aanvalstechnieken
- Jailbreak-benchmarking met gevestigde prompt-aanvalsdatasets
- Tests van adversarial robuustheid die uitvoerafwijkingen bij gewijzigde invoer meten
- Regressietests van gedrag tussen modelversies
- Evaluatie tegen gepubliceerde veiligheidsbenchmarks
NIST, Anthropic, OpenAI, Microsoft, Google en CISA adviseren AI-specifiek red teaming vóór implementatie van systemen met hoog risico. Dit wordt een standaardverwachting, geen optionele praktijk.
Geen van de huidige AI-governancecertificeringen bereidt professionals voldoende voor op het bepalen van de scope, uitvoeren of interpreteren van red teaming tegen een geïmplementeerd model of agent. Ze beschrijven wat red teaming is, maar leren je niet om het uit te voeren.
AI-observability is een apart vakgebied
Traditionele beveiligingslogging is niet rechtstreeks toepasbaar op AI-systemen. Voor monitoring van een LLM of agent in productie zijn andere gegevensverzameling en analyses nodig.
AI-observability omvat:
- Prompt- en uitvoertelemetrie voor anomaliedetectie en herkenning van beleidsschendingen
- Logs van toolaanroepen door agenten, met de gebruikte tools en argumenten
- Monitoring van de ophaalkwaliteit in RAG-pipelines
- Detectie en classificatie van jailbreakpogingen
- Monitoring van uitvoerconsistentie om modeldrift tussen versies te detecteren
- Bijhouden van hallucinatiepercentages voor toepassingen waar feitelijke nauwkeurigheid belangrijk is
- Latentiepatronen die kunnen wijzen op prompt-injectiepogingen die de context vergroten
Dit vakgebied is in opkomst. In 2026 hebben de meeste organisaties die AI inzetten aanzienlijk minder inzicht in hun AI-componenten dan in hun traditionele infrastructuur. De meeste governancecertificeringen beschrijven niet hoe passende observability voor AI-systemen eruitziet.
AI-incidentrespons is anders dan gewone IR
Bij een traditioneel systeem omvat het IR-draaiboek indamming, forensisch onderzoek en herstel. AI-incidenten roepen vragen op die het standaarddraaiboek niet behandelt.
Bereid draaiboeken voor deze vragen voor voordat je ze nodig hebt:
- Hoe bepaal je of een model tijdens fine-tuning is vergiftigd
- Hoe beoordeel je of RAG is misbruikt om inhoud onder controle van een aanvaller terug te geven
- Hoe stel je vast of een agent niet-geautoriseerde acties uitvoerde en wat de reikwijdte was
- Hoe controleer je of een modelupdate van een externe leverancier gedrag veranderde op een manier die relevant is voor beveiliging
- Hoe leg je het gedrag van een model vóór een incident vast om dit met gedrag na het incident te vergelijken
Deze vragen vereisen voorbereiding vóór een incident, vooraf ingestelde logs en telemetrie, en AI-specifieke draaiboeken met ruimte voor forensisch onderzoek naar modelgedrag, niet alleen netwerkverkeer en endpointlogs.
Het probleem met het bijwerken van certificeringen
Een structurele reden waarom certificeringen achterlopen, is dat AI-beveiliging sneller verandert dan certificeringscycli kunnen bijhouden.
Security+, CISSP en ISO 27001 behandelen domeinen die zich over jaren ontwikkelen. De belangrijkste aanvalsoppervlakken van netwerken, endpoints en toepassingen zijn relatief stabiel. AI-aanvalstechnieken ontwikkelen zich in maanden. Prompt-injectietechnieken, adversarial aanvalsmethoden en agentische aanvalsoppervlakken zien er in 2026 anders uit dan bij de eerste AI-certificeringen in 2023 en 2024.
Certificeringsorganisaties werken materialen volgens schema’s bij. De OWASP LLM Top 10 kreeg in het eerste jaar een belangrijke herziening. MCP bestond nog niet als enterprise-aandachtspunt toen veel huidige AI-certificeringen werden ontworpen. Kaders voor agentische AI-beveiliging zijn van na de meeste huidige curricula.
Dit is een structureel probleem, geen gebrek aan goede bedoelingen. Lees doorlopend primaire bronnen in plaats van een certificering als een vaste kennisbron te behandelen.
Wat in certificeringen voor AI-beveiliging moet staan
Om huidige AI-beveiligingspraktijken weer te geven, moeten certificeringscurricula het volgende behandelen:
- Defense-in-depth tegen prompt injection: invoerfiltering, uitvoervalidatie, toolscoping, sandboxing en menselijke goedkeuring, plus de gedocumenteerde beperkingen van elke maatregel
- Verificatie van de modeltoeleveringsketen: risico’s van onveilige serialisatie, SBOM-vereisten, documentatie van herkomst en verificatie van ondertekende artefacten
- Beveiligingsarchitectuur voor AI-agenten: vertrouwensgrenzen, minimaal noodzakelijke tooltoegang, omkeerbaarheid van acties en monitoringvereisten
- MCP- en externe-integratiebeveiliging: vertrouwen in toolservers beoordelen, toolmachtigingen auditen en gegevens van instructies scheiden
- Evaluatie en red teaming: scope bepalen voor adversarial evaluaties, bestaande benchmarks en evaluatiedatasets kennen en resultaten interpreteren
- AI-observability: benodigde logs en telemetrie voor AI-systemen en hun gebruik bij incidentdetectie en -respons
- AI-specifieke incidentrespons: AI-scenario’s vooraf plannen, bewijs over modelgedrag verzamelen en herstelbehoeften beoordelen
- Voorkomen van datalekken: RAG-isolatie, promptvertrouwelijkheid, toegangscontrole voor meerdere tenants en uitvoerfiltering
Wat je nu moet doen
Als je verantwoordelijk bent voor AI-systemen binnen je organisatie:
Lees de OWASP Top 10 for Large Language Model Applications en de OWASP Agentic AI Top 10. Ze zijn gratis en operationeel specifieker dan de huidige betaalde certificeringscurricula.
Bekijk MITRE ATLAS vóór je volgende threat-modelingsessie voor een AI-component. Weet welke aanvallertactieken op je architectuur van toepassing zijn voordat je het implementatieontwerp afrondt.
Lees NIST AI 600-1. Dit breidt het basis-AI RMF specifiek uit voor generatieve AI en is veel relevanter voor LLM- en agentimplementaties dan het basisframework alleen.
Bekijk Google SAIF, Microsoft’s AI SDL en OWASP AI Exchange voor technische richtlijnen die governancekaders niet bieden.
Verifieer de herkomst van elk model dat je organisatie inzet. Controleer modelkaarten. Scan serialisatieformaten op bekende exploitklassen voordat je gewichten laadt.
Breng elke AI-agent in je omgeving in kaart aan de hand van de toegang die deze heeft. Een agent met lees- en schrijftoegang tot je interne kennisbank, e-mail en bestandssysteem versterkt prompt injection. Beperk de referenties tot wat elke taak nodig heeft.
Eis AI-specifiek red teaming voordat je een model of agent in een context met grote gevolgen inzet. Maak het verplicht.
Stel nu AI-specifieke draaiboeken voor incidentrespons op, voordat je ze nodig hebt.
Beschouw je governancecertificering als documentatie van je proceslaag. Het is geen documentatie van je beveiligingsniveau.
Bronnen
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation

Related Posts