Binnen onze hybride AI-agentenvloot: Hermes, LiteLLM en Tailscale

Table of Contents
We hebben een lokale GPU-vloot met GPU-toewijzing per verzoek uitgerold en het hybride besturingsvlak ontworpen. Het geverifieerde pad begint bij LiteLLM, kiest een modelgroep en laadt telkens één lokaal model op één GPU. Het Hermes-beleid voor niveaus is voorgesteld. Een configuratieartefact voor Tailscale Aperture is klaar voor de volgende integratietest. Geen van beide is geverifieerd als onderdeel van één end-to-endroute.
Inactieve kaarten minen Pearl. Een AI-verzoek pauzeert het minen alleen op de geleende kaart, verwerkt het verzoek, laadt het model uit en geeft de kaart terug aan de miner.
Belangrijkste punten
- T0 tot en met T2 verwerken duur of veeleisend werk. Deze routes geven de voorkeur aan gehoste frontiermodellen en geordende terugvalketens.
- T3 verwerkt substantieel lokaal werk. De vloot wijst planning, coderen, controle en visie toe aan modellen van 4B tot 12B.
- T4 verwerkt veelvoorkomend lokaal werk. Kleine modellen routeren, classificeren, extraheren, embedden en voltooien afgebakende codetaken.
- Elke GPU is een zelfstandige bron. Eén kaart verwerkt AI terwijl de overige kaarten blijven minen.
- Lokale modellen blijven uitgeladen wanneer ze niet actief zijn. Tussen verzoekvensters houdt geen model GPU-geheugen bezet.
- Elke gateway biedt dezelfde logische catalogus. Gedeelde aliassen verdelen werk over geschikte systemen. Aliassen met een knooppuntprefix leggen zo nodig de exacte plaats vast.
- De experimentele broker ging niet in productie. De canary verwerkte een verzoek en faalde daarna voor een test van een nette afsluiting. LiteLLM bleef op het geverifieerde pad per verzoek.
- Hermes en Aperture zijn nog voorbereid. Het doelontwerp bestaat, maar end-to-endacceptatietests staan nog open.
Vereisten: meerdere Linux-GPU-hosts, stabiele NVIDIA-stuurprogramma’s, een Tailscale-tailnet, systemd, een werkende miner, modelopslag en acceptatietests voor elke modelroute.
Tijd en moeilijkheid: gevorderd. Trek meerdere dagen uit voor inventarisatie, modeldownloads, servicedefinities, routeringstests, storingssimulaties en controles voor miningherstel per kaart.
Gebruikte termen: een tailnet is het privénetwerk van Tailscale-identiteiten en apparaten. Een modelalias is een stabiele modelnaam die aan clients wordt getoond. Een modelgroep plaatst meerdere implementaties achter één alias. Een poolproxy is een kleine lokale dienst die een GPU leent, de modelworker start en de kaart daarna teruggeeft aan mining.
Het ontwerpdoel
Agentwerk komt in veel vormen voor. Een reparatie aan een repository vraagt een ander model dan een titel, screenshot, embedding of intentielabel. Elke beurt naar het grootste model sturen verspilt geld en lokale capaciteit. Elke beurt naar het kleinste model sturen leidt tot herhalingen en zwakke resultaten.
We wilden één catalogus met vijf werkbanden. Het beleid moest gehoste en lokale modellen via vertrouwde API-indelingen bedienen. Lokale GPU’s moesten tussen AI-verzoeken productief blijven.
De vloot moest ook gelijktijdig werk aankunnen. Een host met meerdere kaarten moet verscheidene onafhankelijke taken tegelijk verwerken. Een verzoek op één kaart mag mining op alle andere kaarten in het chassis niet stilleggen.
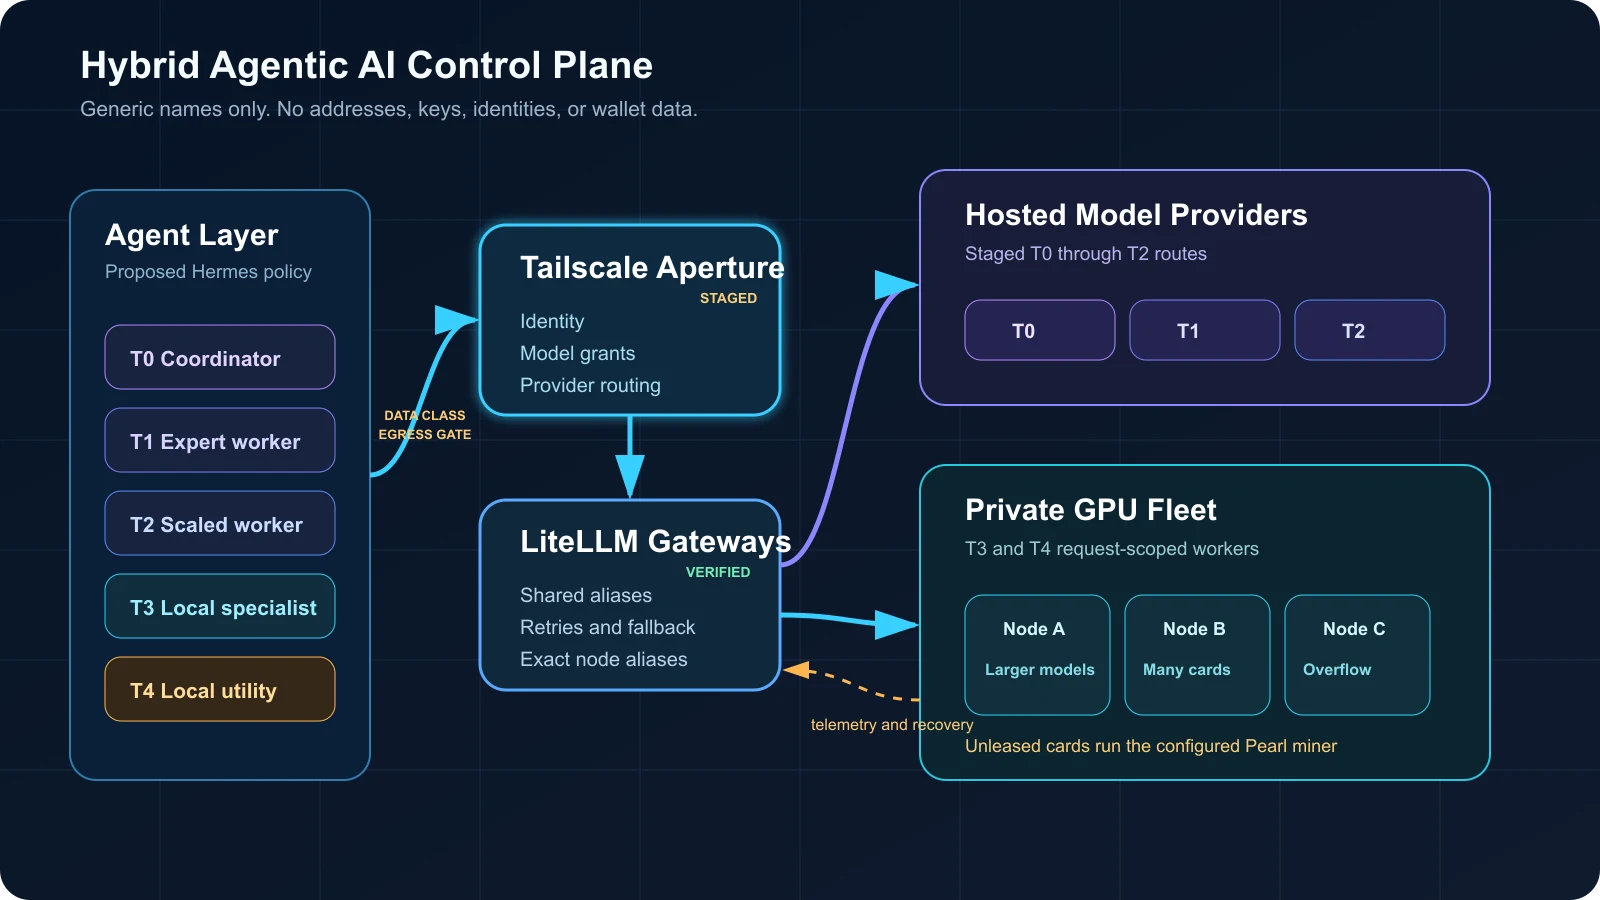
Het voorgestelde en voorbereide besturingspad ligt boven het geverifieerde LiteLLM- en uitvoeringspad per GPU
Het diagram gebruikt algemene knooppuntnamen. Het laat privéadressen, gebruikersidentiteiten, toegangssleutels, walletgegevens en fysieke hostnamen weg.
Wat T0 tot en met T4 betekenen
De niveaunamen zijn ons routeringsbeleid. Ze zijn geen industriestandaard en beschrijven niet alleen de modelgrootte.
| Niveau | Primaire rol | Gebruikelijke bestemming | Gedrag bij fouten |
|---|---|---|---|
| T0 | Standaardcoördinator en moeilijkste besluiten | Gehost frontiermodel voor redeneren | Geordende gehoste terugvalketen |
| T1 | Waardevolle worker-agenten | Gehoste pool met krachtige modellen | Opnieuw proberen binnen de toegewezen keten |
| T2 | Brede pool worker-agenten | Snelle gehoste modellen met opschaling | Moeilijk werk opschalen naar T1 of T0 |
| T3 | Substantieel privé lokaal werk | Lokale chat-, code-, review- en visiemodellen van 4B tot 12B | Een geschikt lokaal knooppunt opnieuw proberen en daarna voor beperkte gegevens gesloten falen |
| T4 | Beperkt en frequent lokaal werk | Modellen van 0,6B tot 3B voor routering, classificatie, code en embeddings | Een lokale replica opnieuw proberen of binnen dezelfde gegevensgrens doorgaan naar T3 |
De niveaus beschrijven eerst de taak en daarna het model. Een korte beveiligingsgevoelige classificatie past bij T4. Een lang repositoryplan past bij T3 of hoger. Een moeilijke architectuurbeslissing begint hoger, zelfs wanneer de prompt kort is.
Deze indeling verandert ook de economie van agenten. T4-workers verwerken herhaalde transformaties met laag risico. T3-workers houden gangbare code en analyse binnen het tailnet. T0 tot en met T2 blijven beschikbaar voor moeilijk werk en herstel na storingen.
Een gegevensclassificatiepoort moet voorafgaan aan elke gehoste terugval. Openbare, interne en beperkte taken krijgen afzonderlijke ketens. Beperkt werk blijft lokaal en faalt gesloten. Een retry over een grens vereist geschoonde invoer plus expliciete goedkeuring van de gebruiker of workflow. Verwijder vóór een gehoste aanroep inloggegevens, repositorygeheimen, privé-uitvoer van tools en gevoelige opgehaalde inhoud.
Hoe Hermes het taakbeleid gaat beheren
Hermes is de voorgestelde agentlaag. Het doelbeleid wijst een modelklasse toe, voert tools uit, delegeert werk en doorloopt expliciete terugvalketens. Hermes documenteert afzonderlijke routes voor het hoofdmodel, hulptaken, gedelegeerde agenten en taakspecifieke terugvalmodellen. Het ondersteunt ook aangepaste OpenAI-compatibele endpoints via een basis-URL. Zie de Hermes-configuratiehandleiding en de handleiding voor terugvalproviders .
Ons beleid koppelt Hermes-taken aan stabiele aliassen in plaats van fysieke servers. Voorbeelden:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
De alias geeft de bedoeling aan. Hermes hoeft niet te weten welke GPU vrij is, welk knooppunt een grotere kaart heeft of welke replica de gezondheidscontrole niet haalde. Lagere lagen nemen die besluiten.
Sommige taken vereisen nog altijd een vaste plaatsing. Een model-ID met knooppuntprefix stuurt een diagnose of benchmark van een operator naar een geselecteerd systeem. Afzonderlijke Aperture-grants moeten deze aliassen beperken tot operators. Normaal agentverkeer gebruikt gedeelde aliassen per niveau.
Modeltoegang beveiligt de tools van een agent niet. Voor de uitrol van Hermes zijn toolallowlists met minimale rechten, geïsoleerde werkruimten, beperkte inloggegevens, regels voor uitgaand netwerkverkeer en verwerking van promptinjecties nodig. Gedelegeerde workers mogen niet meer toegang erven dan hun toegewezen taak vereist.
Aperture als voorbereide identiteitsgrens
Tailscale verbindt de geconfigureerde gateway en inferentiehosts zonder elke dienst openbaar op internet te zetten. Aperture is voorbereid als gebruikersgrens en modelrouter. Deze route heeft nog een end-to-endacceptatietest nodig. Tailscale documenteert versleutelde clienttoegang via het tailnet en TLS-doorsturing naar providers in Hoe Aperture werkt .
Aperture scheidt bereikbaarheid ook van toestemming. Grants weigeren standaard toegang. Een gebruiker of getagd apparaat heeft na het bereiken van de gateway een bijpassende modelgrant nodig. De Aperture-grantgids beschrijft het additieve grantmodel en de identiteitsbronnen.
De voorbereide Aperture-configuratie moet vóór ingebruikname vier regels volgen:
- Eén benoemde identiteit bezit de beheerdersrol. Algemene modeltoegang verleent geen beheerdersrechten.
- Providers vermelden letterlijke model-ID’s. Aperture leidt modellen niet af uit een upstreamdienst.
- Provider-URL’s wijzen naar tailnetadressen. Privéknooppuntnamen en -adressen horen niet in dit artikel of openbare configuratievoorbeelden.
- Geheimen blijven in bestanden die eigendom zijn van de dienst. Pas vóór ingebruikname rechten voor alleen de eigenaar, beperkte serviceaccounts, rotatie en logredactie toe. Diagnostische uitvoer mag nooit LiteLLM-sleutels, tailnetadressen, abonnementstokens of walletgegevens tonen.
Aperture plakt het pad van het inkomende verzoek achter de basis-URL van elke provider. De
configuratiereferentie
waarschuwt tegen een dubbel /v1-achtervoegsel in de providerroot. Dit detail bracht genoeg integratierisico mee om een expliciete validatiecontrole te verdienen.
Vision is voorbereid om via het OpenAI Chat Completions-formaat met afbeeldingsinhoud te lopen. Embeddings gebruiken rechtstreeks het privé-LiteLLM-endpoint omdat de huidige matrix van zelf gehoste Aperture-providers chatformaten documenteert, terwijl onze embeddingroute afhankelijk is van LiteLLM- en llama.cpp-endpoints buiten de chatkiezer. Zie de referentie voor ondersteunde providers en clients .
De directe embeddingroute heeft een eigen autorisatiegrens nodig. LiteLLM-authenticatie, beperkende Tailscale-grants, binding van de dienst aan de tailnetinterface en hostfirewallregels moeten toegang beperken tot goedgekeurde identiteiten of servicetags. Een privé-adres alleen is geen autorisatiebeleid.
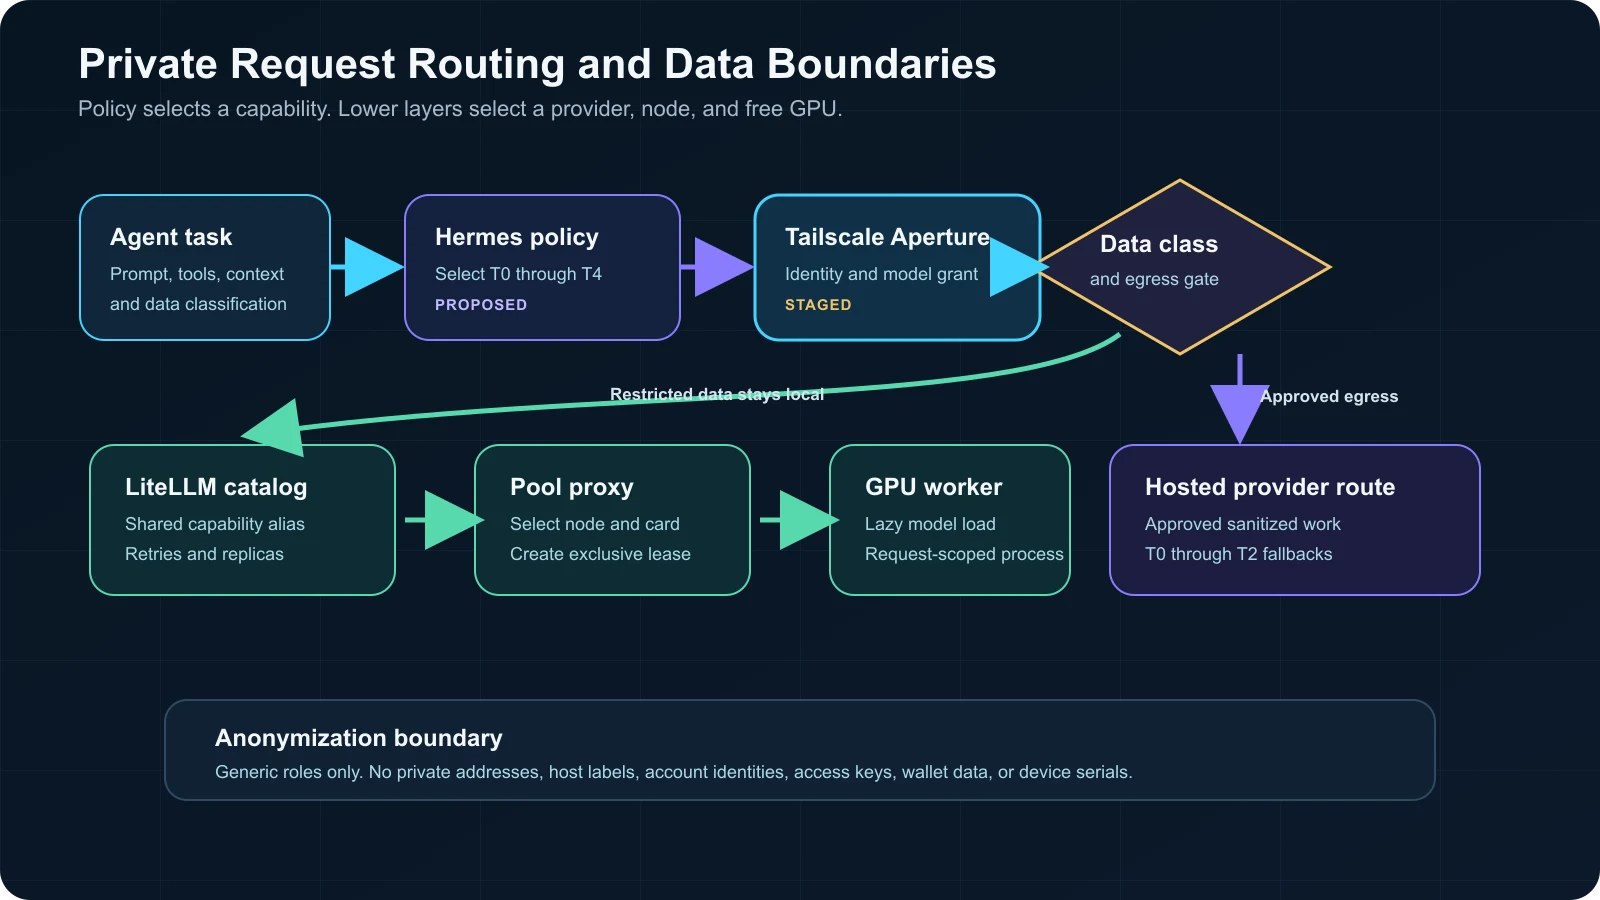
Identiteit, grants en gegevensclassificatie bepalen of een verzoek de privévloot verlaat
LiteLLM biedt één catalogus
Elke inferentiehost draait een LiteLLM-gateway. Alle gateways bieden dezelfde logische modelcatalogus, ook wanneer een model op een ander knooppunt draait. De client behoudt één API-vorm en één set aliassen.
LiteLLM groepeert meerdere implementaties onder één modelnaam. De router kiest vervolgens een geschikte implementatie en past retries, time-outs, afkoelperiodes of terugval toe. De actuele LiteLLM-routeringsdocumentatie beschrijft gedeelde modelnamen, routeringsstrategieën en retrygedrag.
De catalogus heeft twee adresstijlen:
| Adresstijl | Voorbeeld | Gebruik |
|---|---|---|
| Gedeelde alias | t4-classify | Normaal werk verdelen over geschikte knooppunten |
| Knooppuntalias | node-b/qwen-small | Diagnostiek uitvoeren of plaatsing behouden |
Gedeelde aliassen bieden horizontale schaal zonder Hermes te wijzigen. Een geschikte replica toevoegen breidt de modelgroep uit. Een ongezonde replica verwijderen verkleint de groep.
De GPU-levenscycluslogica blijft onder LiteLLM. De gateway blijft warm omdat zijn geheugengebruik geen GPU-geheugen reserveert. Een lokale poolproxy krijgt het geselecteerde modelverzoek, leent één kaart, start de worker en beëindigt deze na het antwoord.
De lokale modelcatalogus
De vloot geeft de voorkeur aan modellen met maximaal 12B parameters. Deze grens past bij het beschikbare kaartgeheugen en laat ruimte voor context en runtimebuffers.
Modelnotatie: B staat voor miljarden parameters. K staat voor duizenden ingestelde contexttokens. Quantisatie slaat modelgewichten op met lagere numerieke precisie om geheugengebruik te verlagen. De KV-cache bevat de aandachtstoestand van de actieve context en groeit met de promptlengte. E4B is Googles aanduiding voor de kleinere Gemma 4-variant.
| Niveau-route | Modelklasse | Ingestelde context | Hoofdtaak | Plaatsing |
|---|---|---|---|---|
| T3 slim | Qwen3.5 9B, gequantiseerd | 64K | Moeilijke lokale planning en algemeen agentwerk | GPU-knooppunten met meer geheugen |
| T3 code | Granite 4.2 8B, gequantiseerd | 64K | Repositorywerk, tools, terminaltaken, gestructureerde uitvoer | GPU-knooppunten met meer geheugen |
| T3 review | Gemma 4 12B, gequantiseerd | 32K | Onafhankelijke review en alternatieve redenering | GPU-knooppunten met meer geheugen |
| T3 algemeen en visie | Qwen3.5 4B, gequantiseerd | 32K | Schaalbaar algemeen werk en beeldbegrip | Elke compatibele GPU |
| T3 alternatieve review | Gemma 4 E4B, gequantiseerd | 8K | Gevarieerde reviewroute | Elke compatibele GPU |
| T4 code | Granite 4.2 3B, gequantiseerd | 16K | Kleine wijzigingen, toolaanroepen, gestructureerde uitvoer | Elke compatibele GPU |
| T4 classificatie | Qwen3.5 2B, gequantiseerd | 16K | Classificatie, extractie en herschrijven | Elke compatibele GPU |
| T4 router | Qwen3.5 0.8B, quantisatie met hoge precisie | 16K | Intentie, labels, titels en korte transformaties | Elke compatibele GPU |
| T4 embedding | Qwen3 Embedding 0.6B, gequantiseerd | 32K | Agentgeheugen, RAG, code ophalen en clusteren | Elke compatibele GPU |
Deze contextwaarden zijn implementatie-instellingen, geen geadverteerde modellimieten. Een groter geadverteerd venster verbruikt nog steeds KV-cache en runtimegeheugen. We kozen lagere waarden voor stabiele verwerking op één kaart.
Qwen beschrijft Qwen3.5 als een multimodale familie en publiceert kleine tot grotere dense varianten in de Qwen3.5-collectie . IBM publiceert resultaten voor agentisch coderen en lange context bij Granite 4.2 8B . Google noemt multimodale invoer, functieaanroepen en een groter geadverteerd venster voor Gemma 4 .
De embeddingroute gebruikt een apart model in plaats van een chatmodel om vectoren te vragen. De modelkaart van Qwen3 Embedding 0.6B noemt een sequentielengte van 32K, meertalige retrieval, code-retrieval en uitvoerdimensies tot 1.024.
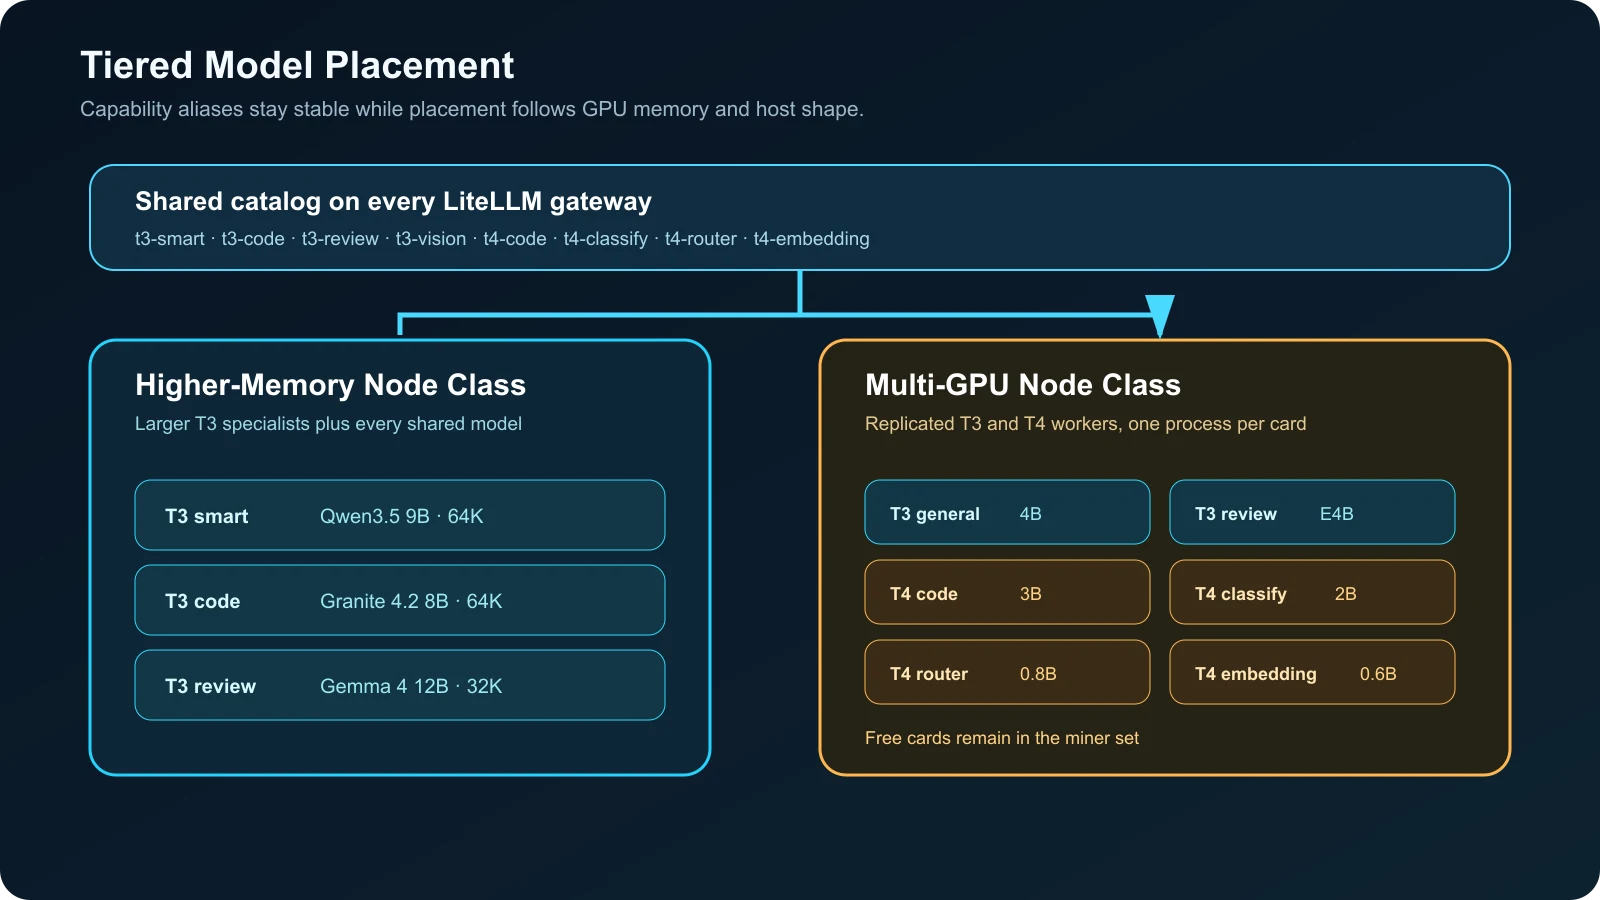
Grotere specialisten blijven op kaarten met meer geheugen, kleinere specialisten repliceren over de vloot
Waarom llama.cpp productie draait
llama.cpp past bij het resourcemodel. Eén statische worker is gekoppeld aan één GPU, één modelbestand, één ingestelde context en één uitleenactie. De procesgrens maakt starten, stoppen, GPU-zichtbaarheid en logs eenvoudig controleerbaar.
De server biedt OpenAI-compatibele chat-, responses- en embeddingroutes. Ook ondersteunt deze parallel decoderen en continue batching. De actuele serverdocumentatie noemt multimodale ondersteuning experimenteel. Deze functies staan in de serverdocumentatie van llama.cpp .
Ollama blijft beschikbaar als compatibiliteitsroute op een groter knooppunt. Ollama ondersteunt meerdere gelijktijdige modelbeladingen wanneer het geheugen volstaat en direct uitladen via keep_alive: 0, zoals beschreven in de
Veelgestelde vragen over Ollama
. We kozen Ollama niet voor de productie per kaart omdat statische llama.cpp-workers ons meer controle over plaatsing en stoppen gaven.
We hebben Strata ook bekeken. Strata richt zich op een groot Qwen-mixture-of-experts-model, verspreid over GPU-geheugen, systeem-RAM en opslag. De gepubliceerde presets beginnen bij 32 GB gecombineerd geheugen. De modus voor weinig RAM ruilt snelheid in voor minder capaciteit. Zie de Strata-codearchief . Strata past bij een ander doel: één groter hybride model op een of meer kaarten. Onze vloot geeft de voorkeur aan veel onafhankelijke workers onder 12B.
Modellen op aanvraag laden per GPU
Deze manier van laden geldt voor elke modelworker. Tussen verzoeken houdt het systeem alleen gateways, poolproxy’s, watchdogs en de miner actief.
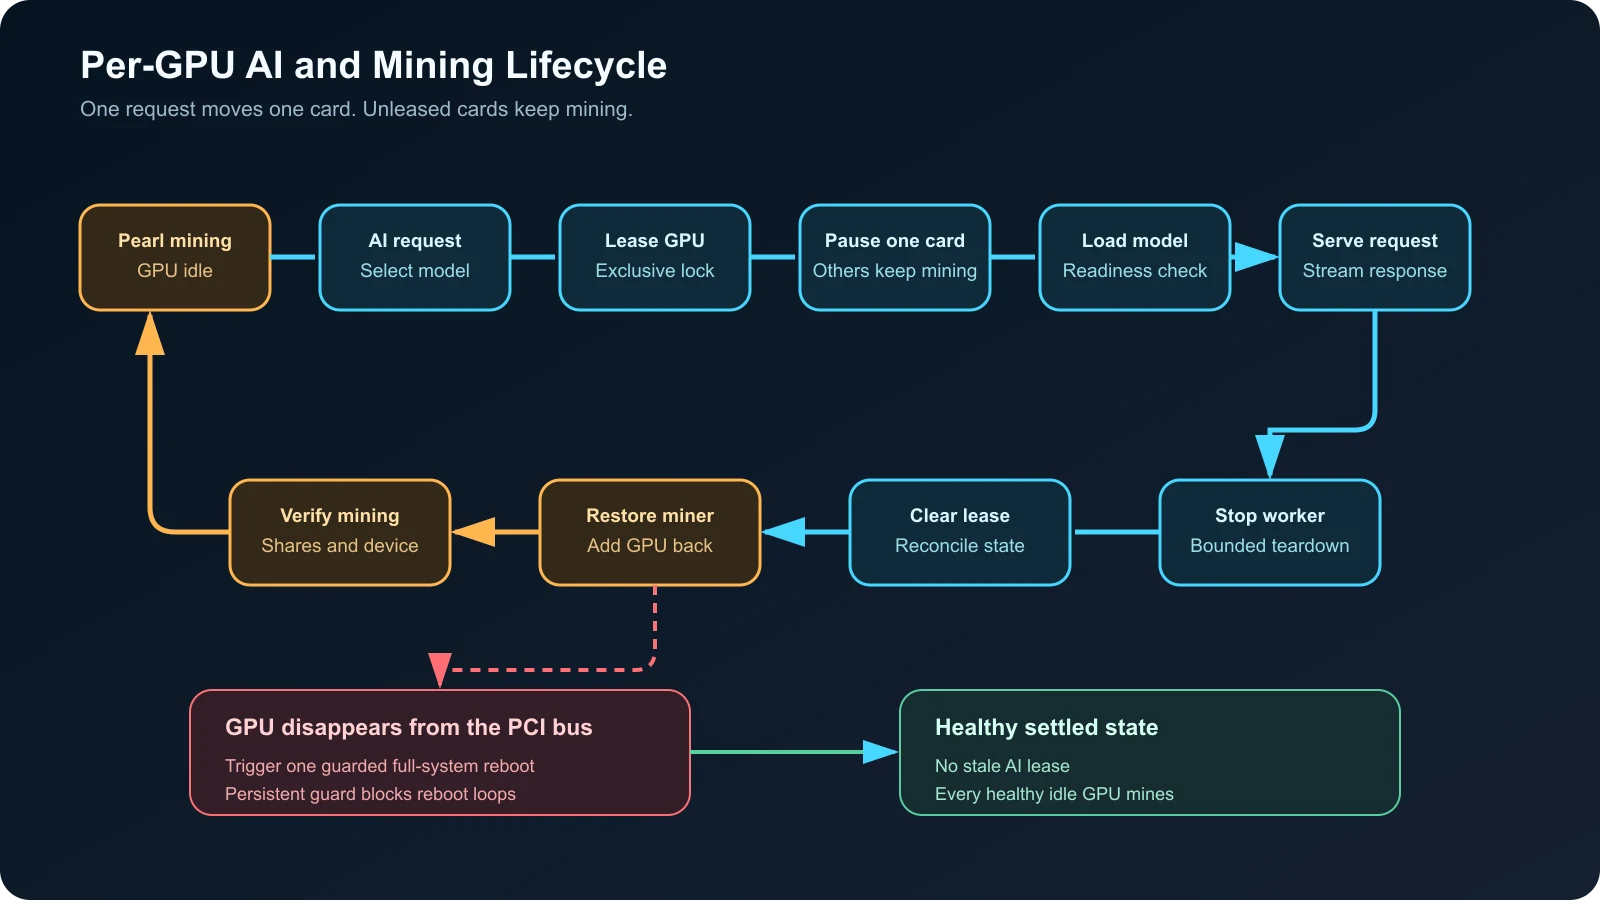
Alleen de geleende kaart verlaat de miner en keert terug nadat het modelproces stopt
De levenscyclus van een verzoek verloopt als volgt:
- LiteLLM selecteert een implementatie. Het verzoek komt bij een poolproxy voor de gekozen modelklasse.
- De pool neemt een uitleenactie. Een lock voorkomt dat twee exclusieve workers dezelfde kaart gebruiken.
- De miner herstart zonder één GPU. Elke niet-uitgeleende kaart blijft opgenomen in het Pearl-commando.
- llama.cpp start op het geleende apparaat. Gereedheidscontroles ronden af voordat de proxy het verzoek doorstuurt.
- De worker verwerkt het antwoord. Gelijktijdige verzoeken starten workers op andere vrije kaarten.
- De worker stopt. De pool verwijdert de uitleenactie zodra het proces is beëindigd.
- De miner herstart met de vrijgegeven GPU. Gezondheidscontroles bevestigen dat de kaart weer mining uitvoert.
Dit is anders dan de hele host in één keer omschakelen. Een chassis met meerdere kaarten verwerkt meerdere modellen terwijl de overige kaarten blijven minen. Een inactieve vloot geeft elke gezonde GPU terug aan Pearl.
Het Achtergrondpapier over Pearl beschrijft het proof-systeem voor matrixberekeningen. Onze architectuur is niet afhankelijk van een rendementsprognose of een claim over financieel resultaat. Mining is de ingestelde taak voor inactieve kaarten.
Foutafhandeling is belangrijker dan opstarten
Het model starten is maar de helft van de levenscyclus. Geforceerd stoppen, verdwenen GPU’s, onderbroken verzoeken, verouderde uitleenacties en minerherstarts vereisen expliciete afhandeling.
Onze watchdog vergelijkt de ingestelde GPU-set met de actieve lijst NVIDIA-apparaten. Een bevestigde ontbrekende GPU veroorzaakt één volledige systeemherstart met beveiligingen. Een veilige productietrigger hoort herhaalde mislukte controles, een cooldown, het afronden van actieve taken, een persistente herstartteller en een melding op afstand te vereisen. Een mislukte herstelactie hoort automatisering te stoppen en handmatig ingrijpen te vereisen.
Dezelfde watchdog verzoent verouderde uitleenacties. Als geen worker een uitleenactie bezit, verwijdert de reconciliatie het oude record en geeft de GPU terug aan de miner. Dit herstelpad was belangrijk tijdens de brokercanary.
| Fout | Reactie |
|---|---|
| Model wordt niet gereed | Stop de worker, geef de uitleenactie vrij, herstel mining en geef een fout terug |
| Verzoek eindigt onverwacht | Beperk de opruimtijd, beëindig de workerprocesboom en verzoen de uitleenactie |
| GPU verdwijnt | Bevestig herhaalde missers, rond actief werk af, voer één beveiligde herstart uit, stuur een melding en controleer daarna de volledige ingestelde GPU-set |
| Miner laat een inactieve kaart weg | Bouw de apparaatlijst opnieuw op uit actieve uitleenacties en herstart de miner |
| LiteLLM-implementatie faalt | Probeer een andere replica in dezelfde modelgroep en volg daarna het terugvalbeleid |
| Aperture-grant blokkeert een route | Herstel de identiteit of modelgrant, omzeil nooit het gatewaybeleid |
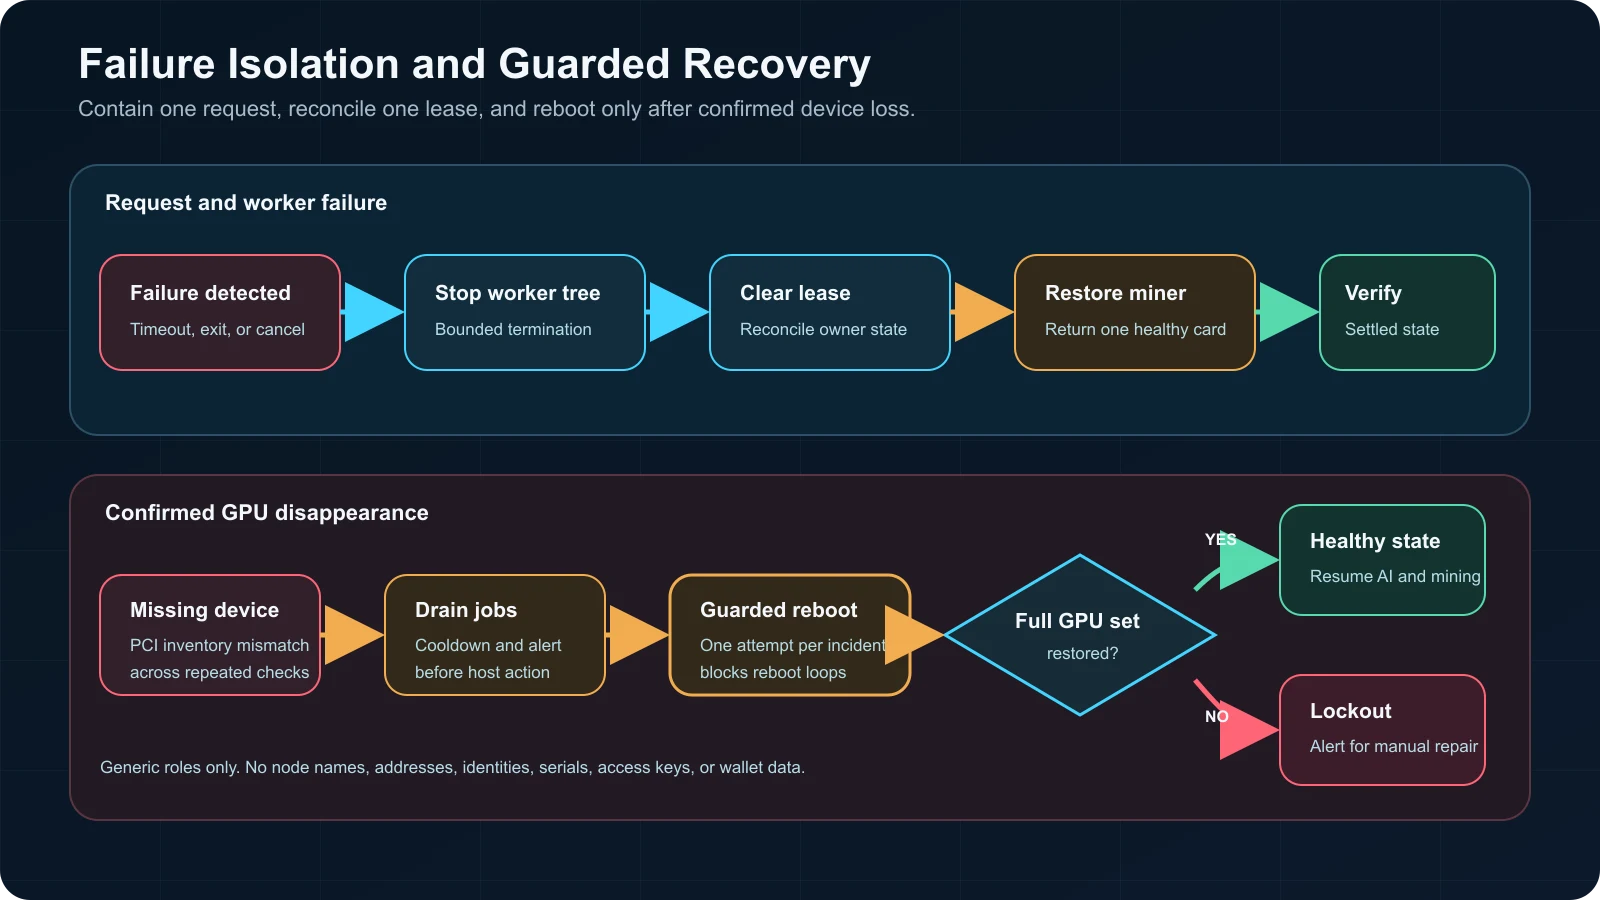
Gewone storingen geven één uitleenactie vrij; bevestigd apparaatverlies activeert het beveiligde herstelpad van de host
Wat er met de experimentele broker gebeurde
De backendagnostische broker wil één OpenAI-compatibel oppervlak bieden voor Ollama, vLLM, llama.cpp en Strata. De broker bevat levenscyclusbeheer per model, uitladen bij inactiviteit en GPU-plaatsing.
We testten broker-versie 0.6.0 op commit c12b65 op 21 oktober 2026. De lokale testsuite meldde 1.101 geslaagde tests en 2 overgeslagen tests, en Ruff was schoon. De canary laadde daarna op verzoek een model en verwerkte een geslaagd chatverzoek. Andere GPU’s bleven tijdens het verzoek minen.
Het stoppen bracht een kritiek levenscyclusprobleem aan het licht. Nadat een model was geladen, bleef de broker in het stopproces hangen totdat systemd de procesboom beëindigde. Door het geforceerd stoppen bleef een oude GPU-uitleenactie achter totdat reconciliatie de miner herstelde. We vonden ook een verschil tussen de gedocumenteerde instelling voor verplichte GPU’s en de handhaving in de productieadapter.
We hebben de broker uit het productiepad gehaald. LiteLLM routeert nu via de poolproxy per verzoek. De broker blijft experimenteel totdat integratietests begrensd stoppen van childprocessen, beëindigen van procesgroepen, toelatingscontroles voor verplichte GPU’s en opruimen van oude uitleenacties doorstaan.
Dit resultaat levert een nuttige technische les op. Een broker bewijst weinig als deze één keer een model start. Productiegereedheid hangt af van schoon stoppen, begrensd herstel, exclusieve apparaattoegang en herhaalbare storingssimulaties.
Uitgevoerde verificaties
De implementatietest controleerde meer dan een modelantwoord:
- Elk gedeeld chatmodel voltooide laden, antwoorden, stoppen en Pearl-herstel op ten minste één geschikt host.
- Visie accepteerde beeldinvoer via de chatroute.
- Embeddings leverden de ingestelde vectorgrootte via het privé-LiteLLM-pad.
- Meerdere modellen draaiden tegelijk op afzonderlijke kaarten.
- Niet-uitgeleende kaarten bleven tijdens gelijktijdige AI-verzoeken bij de miner.
- Gedeelde aliassen routeerden over geschikte knooppunten.
- Aliassen met knooppuntprefix behielden een deterministische plaatsing.
- Elke LiteLLM-gateway vermeldde dezelfde logische catalogus.
- Een ontbrekende GPU herstelde na één volledige herstart van de host. De watchdog heeft nu een persistente lusbeveiliging.
- Een brokerstoring tijdens het stoppen herstelde via uitleenreconciliatie.
- De uiteindelijke stabiele toestand had geen AI-uitleenacties en elke gezonde GPU stond weer in de minerset.
Gezondheidscontroles en modellijsten telden niet als tests voor het laden van een model. Een bruikbare acceptatietest verstuurt een echt verzoek, controleert het antwoord, bevestigt de gekozen GPU, volgt het stoppen en verifieert miningherstel.
Problemen met de vloot oplossen
| Symptoom | Eerste controle |
|---|---|
| Model is zichtbaar maar verzoeken falen | Upstream-model-ID, API-indeling, authenticatieheader en basis-URL van provider |
| Aperture geeft 405 terug | Providerroot bevat geen dubbel /v1-achtervoegsel |
| Verzoek wordt op het verkeerde knooppunt verwerkt | Gedeelde alias versus alias met knooppuntprefix |
| Twee workers richten zich op dezelfde kaart | Uitleenlock, oude uitleenstatus en GPU-toelatingslogica |
| Mining stopt op elke kaart | De miner-herstartcode bouwt de apparaatlijst op uit actieve uitleenacties |
| GPU blijft buiten mining | Workerprocesboom, uitleenreconciliatie en apparatenlijst van miner |
| Koude start duurt lang | Modelgrootte, opslagsnelheid, PCIe-linkbreedte en CPU-belasting van host |
| Lange prompts mislukken | Ingestelde context, KV-cachemarge en uitvoerreservering |
| Embeddingroute ontbreekt in Aperture | Gebruik de geauthenticeerde LiteLLM-route, beperkt door Tailscale-identiteit en hostfirewallbeleid |
| Broker blijft hangen bij stoppen | Schakel de brokerroute uit en stuur verkeer terug naar de geverifieerde poolproxy |
Ontwerpregels die het waard zijn te bewaren
- Routeer op het doel van het werk. Modelgrootte alleen bepaalt geen niveau.
- Houd beleid boven plaatsing. Hermes kiest een capaciteitsalias. LiteLLM kiest een implementatie. De pool kiest een GPU.
- Behandel elke GPU als een afzonderlijke uitleenactie. De hele host omschakelen verspilt beschikbare kaarten.
- Laad elk inactief model uit. Warme gateways vereisen geen warme GPU-workers.
- Behoud een beperkte route voor exacte plaatsing. Aliassen voor operators met knooppuntprefix maken diagnoses reproduceerbaar.
- Test stoppen eerst. Minerherstel en opruimen van uitleenacties horen in acceptatietests.
- Scheid chat, visie en embeddings. Eén gateway betekent niet één protocolroute.
- Houd privégegevens uit diagrammen. Publiceer rollen en stromen, niet adressen, sleutels, identiteiten of walletgegevens.
- Beveilig herstartlogica. Vereis herhaalde missers, cooldown, persistente teller, melding en handmatig ingrijpen na één mislukte herstelactie.
- Houd een experimentele omweg. Een mislukte broker mag de geverifieerde route niet meeslepen.
Volgende stappen
De volgende fase evalueert de werklast. Elk niveau heeft een vaste takenreeks, acceptatiecriteria, latentieregistraties, GPU-bezetting, onderbrekingstijd voor mining en opschalingspercentages nodig. Die metingen laten zien welke T2-taken bij T3 horen en welke T3-taken in T4 passen.
We willen ook de eerste acceptatietest voor Hermes via Aperture via LiteLLM uitvoeren en de broker opnieuw testen nadat het stop- en GPU-toelatingspad is hersteld. Beeldgeneratie heeft een eigen OpenAI-compatibele adapter met lazy loading nodig voordat deze in dezelfde routeringscatalogus komt.
Lees voor modelgrootte de gids voor lokale AI-modellen en GPU-context . Lees voor privacygrenzen Lokale AI-privacy en -beveiliging . Lees voor minerinstallatie en risico’s de Pearl-mininggids in plaats van inactieve mining als gegarandeerde winst te zien.
Related Posts