Is 16 GB VRAM genoeg voor serieus lokaal LLM-werk?
Table of Contents
16 GB toegewezen GPU-geheugen ondersteunt serieus lokaal LLM-werk wanneer model, context en runtime samen passen. Het laden van de gewichten bewijst alleen de eerste voorwaarde. Een bruikbare configuratie heeft ook genoeg geheugen nodig voor je lopende gesprek en genoeg snelheid om je taak af te ronden.
Gebruik Qwen3.8 27B als uitgewerkt voorbeeld voor een codeer- of documentworkflow voor één gebruiker. Begin met de context die je taak nodig heeft. Kies daarna gewichten en runtime-instellingen die in het resterende geheugen passen. Hardware-specificaties en modelbronnen zijn gecontroleerd op 7 oktober 2026.
Belangrijkste punten
- Reserveer geheugen voor context voordat je een kwantisatie kiest.
- Meet promptverwerking apart van uitvoersnelheid.
- Schakel ongebruikte visionondersteuning uit en test een 8-bits KV-cache.
- Vergelijk de exacte GPU, backend, modelbestand en promptlengte.
- Bereken besparingen op basis van je werklast en de rekening van je provider.
Voor deze budgetoefening heb je het geheugenlog van je runtime, de exacte bestandsnaam van het model en een representatieve taak nodig. Reken ongeveer 20 minuten voor instellen en resultaten vastleggen, plus inferentietijd. De moeilijkheidsgraad is gemiddeld.
Stem geheugen af op het werk
16 GB past bij een werklast waarvan gewichten, actieve context en tijdelijke toewijzingen binnen het beschikbare GPU-geheugen blijven. Je benodigde context hangt van de taak af. Een korte documentsamenvatting en een codeeragent die tientallen bestanden leest hebben verschillende budgetten nodig.
| Werklast | Eerste vraag bij dimensionering |
|---|---|
| Korte chat of concept | Haalt het model je kwaliteitsdoel? |
| Documentanalyse | Passen brontekst en antwoord samen? |
| Codeeragent | Hoeveel context gebruiken bestanden en toolresultaten? |
| Gelijktijdige aanvragen | Hoeveel cache heeft elke actieve sessie nodig? |
Een ingesteld venster verschilt van een gevuld venster. Een benchmark met een limiet van 64K en een korte prompt meet geen generatie na 55K gesprekstokens. Test dicht bij de verwachte sessielengte voordat je hardware kiest.
Waarom het model past
Kwantisatie slaat gewichten met minder bits op. De Qwen3.8 27B-bestandstabel van Bartowski vermeldt Q4_K_M op 17.44 GB. Dat ligt al boven de ongeveer 17.18 miljard bytes van een apparaat met 16 GiB, nog vóór runtimegeheugen.
De GSQ-RCO-modelkaart van ISTA-DASLab vermeldt IQ3_S op 11.8 GB. De methode geeft verschillende tensors binnen een groottebudget verschillende precisies. De optionele MTP-versie voegt ongeveer 0.35 GB toe. De visionprojector voegt ongeveer 0.9 GB toe.
| Gepubliceerde benchmark | BF16 / IQ3_S-score |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Het lab noemt dit werkpunt “task-lossless”. Deze geselecteerde resultaten ondersteunen een beperkte vergelijking. Ze bewijzen geen identieke antwoorden, gelijke retrieval over lange context of gelijke betrouwbaarheid bij jouw codeertaken. Test het gecomprimeerde model tegen je eigen acceptatiecriteria.
Tel de cache
De KV-cache bewaart attention-sleutels en -waarden voor al verwerkte tokens. Je prompt, tooluitvoer en gegenereerde antwoorden gebruiken context. Sommige runtimes wijzen cachecapaciteit bij het opstarten toe. Het weergegeven geheugen hoeft daarom niet met elk bericht te groeien.
De configuratie van Qwen specificeert 64 lagen, volledige attention bij elke vierde laag, vier KV-heads en een headdimensie van 256. Voor de 16 lagen met volledige attention zijn de berekende FP16-cachekosten:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Deze berekening sluit recurrente toestand, uitlijning, tijdelijke buffers en allocaties voor speculatieve decoding uit. Andere architecturen vragen andere berekeningen.
| Gevulde tokens | FP16-cache voor volledige attention |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
KiB en GiB gebruiken hier machten van 1024. Modeldownloads gebruiken decimale GB. Eenheden mengen vertekent het resterende budget.
Bereken je beschikbare contextbudget
Twee instellingen maken geheugen vrij voor langere tekstsessies: verwijder een ongebruikte visionprojector en verlaag de cacheprecisie. Bereken het effect ten opzichte van je geladen model en runtimeallocaties.
Gebruik dit voorbeeld, met iedere allocatie in decimale GB. De reserve van 1.0 GB is een planningsaanname, geen universele standaardwaarde van een runtime.
| Allocatie | Vision aan / vision uit |
|---|---|
| Fysieke capaciteit 16 GiB | 17.180 / 17.180 GB |
| Modelgewichten | 11.800 / 11.800 GB |
| Optionele MTP-head | 0.350 / 0.350 GB |
| Schatting visionprojector | 0.930 / 0 GB |
| Aangenomen andere allocaties | 1.000 / 1.000 GB |
| Over voor groeiende cache | 3.100 / 4.030 GB |
Bij 65,536 bytes per token bevat 3.100 GB ongeveer 47,300 tokens. Ideale 8-bits opslag gebruikt 32,768 bytes per token en bevat met vision uit ongeveer 123,000 tokens.
Echte q8_0-opslag bevat blokschalen. Bij 34 bytes per 32 waarden heeft dit voorbeeld ongeveer 34,816 bytes per token nodig. De schatting daalt dan naar ongeveer 115,700. Extra allocaties verlagen het resultaat verder. Ongeveer 110K is onder deze aannames dus een plausibel planningsresultaat, geen gegarandeerde instelling.
De resterende context moet input en output bevatten. Met een venster van 65,536 tokens, een illustratieve eerste prompt van 30,000 tokens en ruimte voor 8,192 outputtokens blijven 27,344 tokens over voor bestanden, toolresultaten en gesprek. Het budget voor de eerste prompt is een voorbeeld. Meet je eigen tools en instructies.
Instellingen die je moet testen
De llama.cpp-serverdocumentatie beschrijft aparte sleutel- en waardecachetypen, automatisch laden van de projector en parallelle slots. Test voor tekst zonder vision vision uit, q8_0 voor beide cachetypen en één slot. Begin met een bescheiden context.
Leg de allocaties vast voordat je de context vergroot. Cachekwantisatie vereist ondersteuning van je gekozen architectuur en backend. Test de antwoordkwaliteit na een wijziging van de precisie. Bewaar een werkende configuratie voor vergelijking.
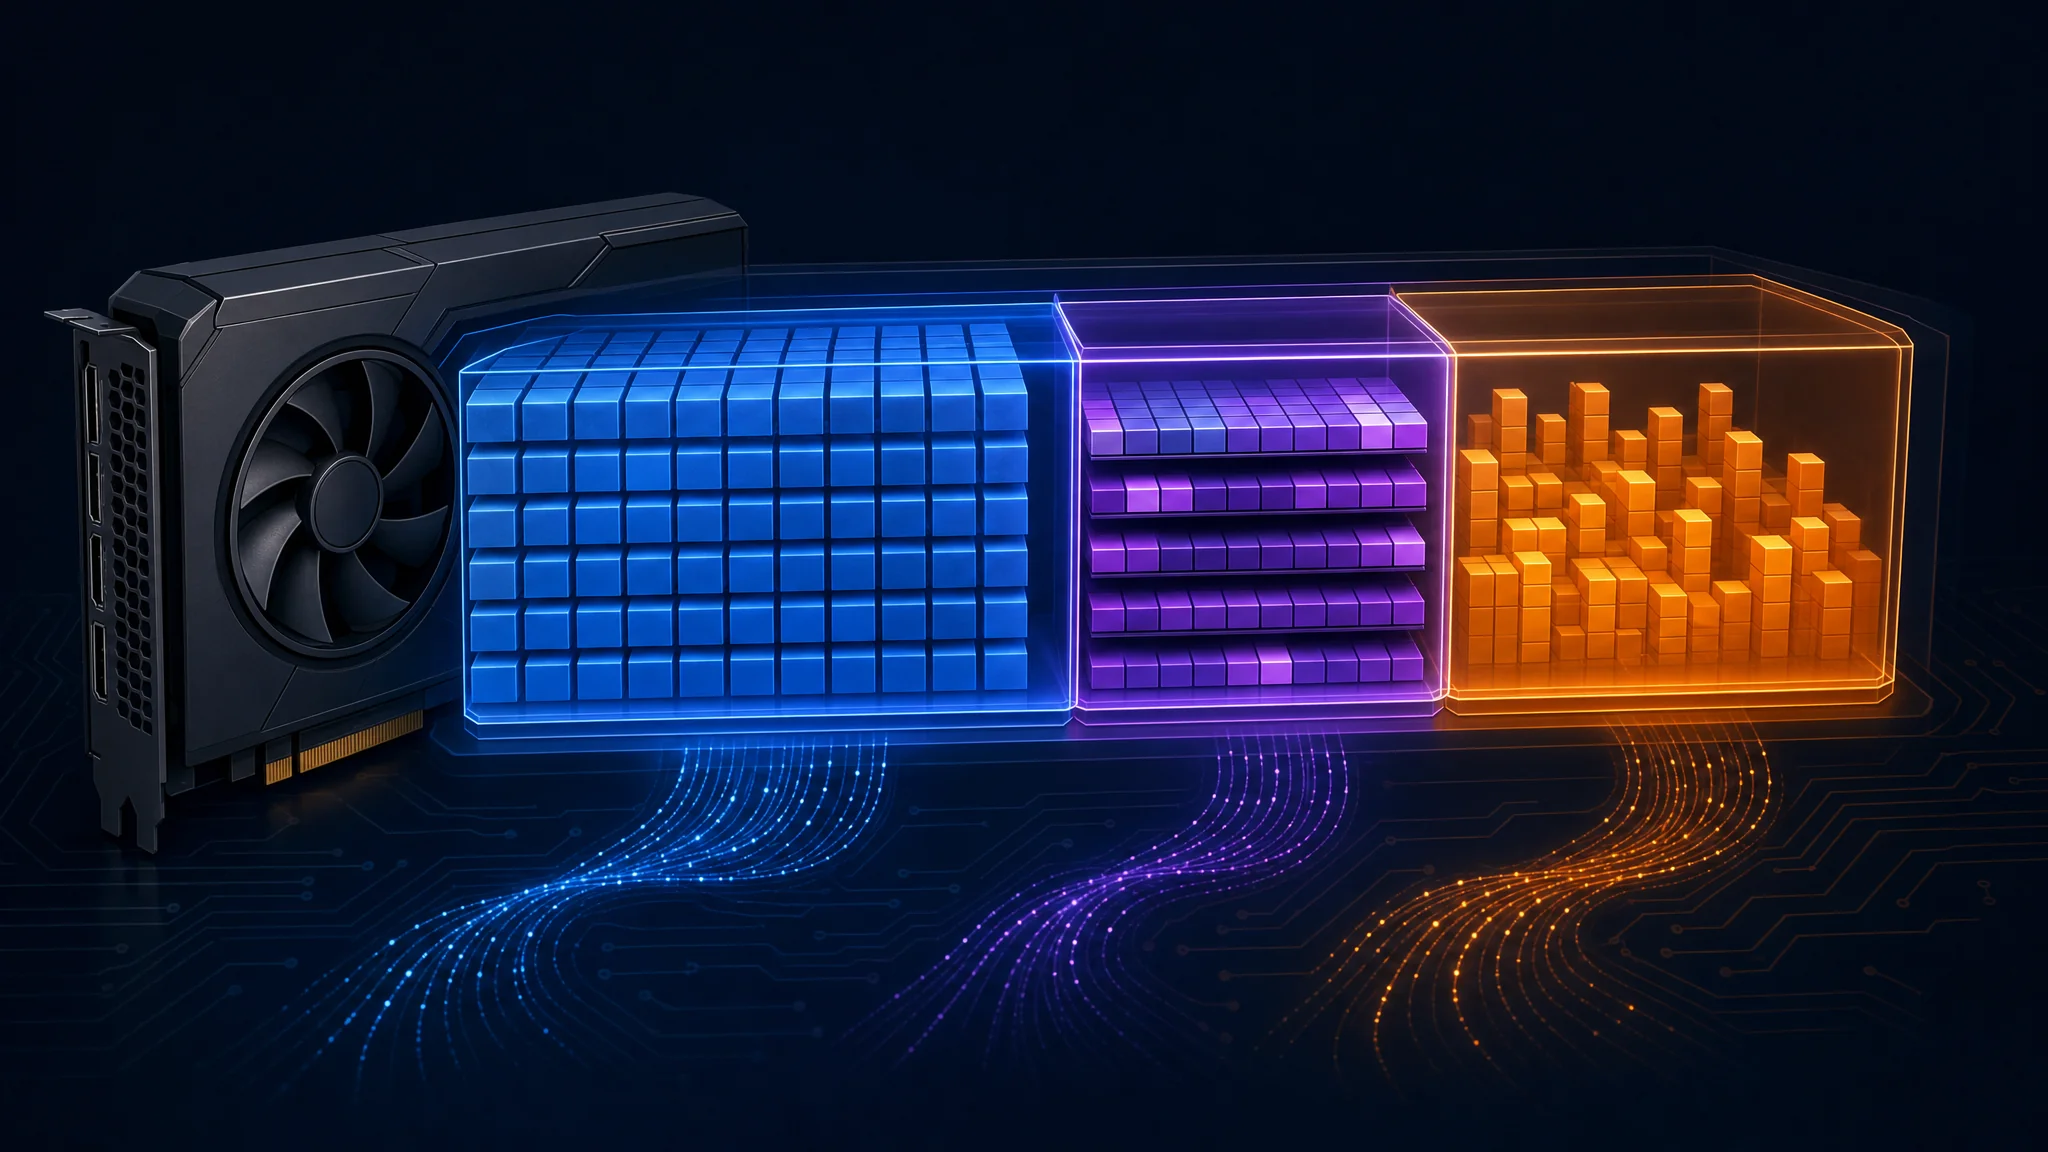
Blauw staat voor gewichten, paars voor contextcache en oranje voor runtimeallocaties. De afmetingen zijn illustratief
Waarom snelheden verschillen
Een label van 16GB beschrijft capaciteit. Doorvoer hangt ook af van geheugenbandbreedte, rekenkernels, actieve context, offload, batching en speculatieve decoding.
| Oorzaak | Wat je moet controleren |
|---|---|
| CPU- of RAM-offload | Plaatsing van geladen lagen en cachelocatie |
| Lange context | Gevulde tokens tijdens de meting |
| Backendverschillen | Runtime-commit, driver en kernelpad |
| Speculatieve decoding | Geaccepteerde drafts en extra allocaties |
Voor een dicht model dat telkens één token genereert geeft geheugenbandbreedte gedeeld door residente gewichtbytes een ruwe schatting op basis van bandbreedte. Bij 448 GB/s en 11.8 GB gewichten is het quotiënt ongeveer 38 tokens per seconde. Cachelezingen en berekening voegen werk toe. Speculatieve decoding en batching veranderen de aannames.
Behandel dit quotiënt niet als een universele bovengrens. Een hogere gerapporteerde uitvoersnelheid maakt een benchmark niet automatisch ongeldig. Controleer of één passage van het doelmodel meerdere drafttokens accepteerde.
Multi-tokenvoorspelling, of MTP, vereist een compatibel model en een compatibele runtime. Vergelijk runs met MTP aan en uit bij korte en lange gevulde context. Extra gewichten en drafttoestand gebruiken geheugen, maar er is geen universele regel die MTP na 32K tokens uitschakelt.
Meet het eerste antwoord
Prefill verwerkt de prompt vóór generatie. Decode produceert het antwoord. Een snelle decode-uitkomst verbergt een traag eerste antwoord wanneer een taak met een grote niet-gecachete prompt begint.
Deel ongecachete prompttokens door de gemeten prefill-doorvoer om de promptverwerkingstijd te schatten. Voor een nieuwe prompt van 30,000 tokens geven twee illustratieve snelheden deze wachttijden:
| Voorbeeldsnelheid prompt | Berekende verwerkingstijd |
|---|---|
| 750 tokens/s | 40 seconden |
| 150 tokens/s | 200 seconden |
Deze voorbeelden beschrijven verwerkingstijd, zonder modelladen en aanvraagoverhead. Promptlengte, batchgrootte, modelformaat en backend beïnvloeden je gemeten snelheid.
Meet een koude aanvraag en een voortzetting met een herbruikbaar prefix apart. Prefixhergebruik voorkomt verwerking van herhaalde input. Noteer tijd tot het eerste token naast decode-snelheid en totale taakduur.
Vergelijk complete GPU-configuraties
Vergelijk aankoopprijs, bruikbaar geheugen, bandbreedte en softwarepad samen. Een goedkopere kaart verliest haar voordeel als je werklast niet-ondersteunde functies vereist of je latentie-doel overschrijdt.
| 16GB desktopkaart | Geheugenbandbreedte |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
AMD’s specificaties voor RX 9070 en specificaties voor RX 9070 XT bevestigen 16GB capaciteit en tot 640 GB/s bandbreedte. De vergelijking 640 met 448 levert ongeveer 43% meer theoretische bandbreedte. Daaruit volgt geen inferentieverbetering van 43%.
Kies benchmarks met je bedoelde model en backend. Geef voor korte prompts en aanhoudende generatie meer gewicht aan decodeprestaties. Geef bij repositoryanalyse voorrang aan koude prefill, snelheid bij lange context en geslaagde taakuitvoering. Controleer beschikbare software voordat je een van beide merken koopt.
Macs en laptoplabels
Een Apple-silicon-Mac met 16GB deelt geheugen tussen CPU, GPU, besturingssysteem en toepassingen. Een discrete GPU met 16GB heeft toegewezen videogeheugen naast systeem-RAM. Deze capaciteiten beschrijven geen gelijke modelbudgetten.
Apple publiceert een aanbevolen GPU-working-setgrootte . Controleer de door je runtime gemelde limiet en de systeemgeheugendruk. Laat ruimte voor macOS en andere toepassingen in plaats van de hele gedeelde pool voor inferentie te reserveren.
Controleer bij laptops het exacte SKU, toegewezen geheugen, GPU-vermogenslimiet en koeling van de fabrikant. De RTX 5060-familiepagina van NVIDIA vermeldt geheugenvarianten van de desktop-RTX 5060 Ti. Een familienaam bewijst geen 16GB. Desktopresultaten bewijzen geen laptopdoorvoer.
Loont eigendom?
Eigendom loont financieel wanneer vermeden hostingkosten hoger zijn dan bedrijfskosten en de aankoop terugverdienen. Begin met een voorbeeld voor alleen output: een kaart van $789, 35 outputtokens/s, 180W tijdens generatie, elektriciteit van $0.18/kWh en $2.95 per miljoen gehoste outputtokens. Dit zijn illustratieve invoerwaarden. Vervang ze door je aankoopofferte, gemeten vermogen, elektriciteitstarief en providerprijzen.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Bij acht uur ononderbroken generatie per dag duurt dezelfde berekening ongeveer 291 dagen. Acht uur met een geopende assistent verschilt van acht uur tokens genereren.
Bij een gehoste outputprijs van $0.16 per miljoen kost lokale elektriciteit in dit scenario al meer dan hosting. Onder deze aannames bestaat er geen positief break-evenpunt voor alleen output.
Gebruik de actuele OpenRouter-modelprijzen van de gekozen provider, inclusief kosten voor input en gecachete input. Meet energie voor het hele systeem, inclusief prefill. Voeg upgrades, idle-energie, onderhoud en verwachte restwaarde toe. Vergelijk geaccepteerd werk, want herhaalde pogingen en kwaliteitsverschillen veranderen de kosten per taak.
Wanneer extra geheugen nodig is
Ga voorbij 16GB wanneer je gemeten werklast de beschikbare context overschrijdt bij aanvaardbare kwaliteit en latentie. Dagelijkse lange agentsessies, gelijktijdige aanvragen of gewichten met hogere precisie maken grotere capaciteit nuttig.
Twee kaarten van 16GB vereisen expliciete runtimeondersteuning. Ze worden geen transparante allocatie van 32GB. Elk apparaat heeft buffers nodig. Communicatie gebruikt de interconnect van de host.
| Verdelingsstrategie | Belangrijkste compromis |
|---|---|
| Lagen verdelen | Verschillende lagen bezetten verschillende apparaten |
| Tensor- of rijverdeling | Werk binnen lagen voegt communicatie toe |
| CPU plus GPU | Meer capaciteit met een ander latentieprofiel |
Een tweede kaart verdient aandacht wanneer moederbord, voeding, koeling en backend het plan al ondersteunen. Vergelijk de volledige systeemkosten met één grotere GPU. De hardwaregids voor 32GB Qwen behandelt deze alternatieven.
Problemen oplossen en volgende stappen
Verlaag bij mislukte lading de context en inspecteer allocaties. Controleer bij dalende snelheid tijdens een sessie de gevulde context en CPU-offload. Meet koude prefill wanneer het eerste antwoord hapert. Vergelijk bij kapotte toolinteractie na compressie dezelfde taak met een model met hogere precisie.
Bewaar één herhaalbare test met je normale instructies, bestanden en tooluitvoer. Noteer modelrevisie, runtimeversie, cacheprecisie, gevulde context, piekgeheugen, latentie tot het eerste token, decode-snelheid en geslaagde taak. Herhaal dicht bij je langste verwachte sessie.
Gebruik de gids voor lokale modellen en context om kleinere alternatieven te vergelijken. Kies het kleinste model dat aan je kwaliteitseisen voldoet en reserveer daarna genoeg geheugen voor de volledige taak. Onder deze omstandigheden is 16GB een bruikbaar werkstationdoel.
Related Posts