Provider-routing in OpenRouter: modelkwaliteit, tokenlimieten en werkelijke kosten
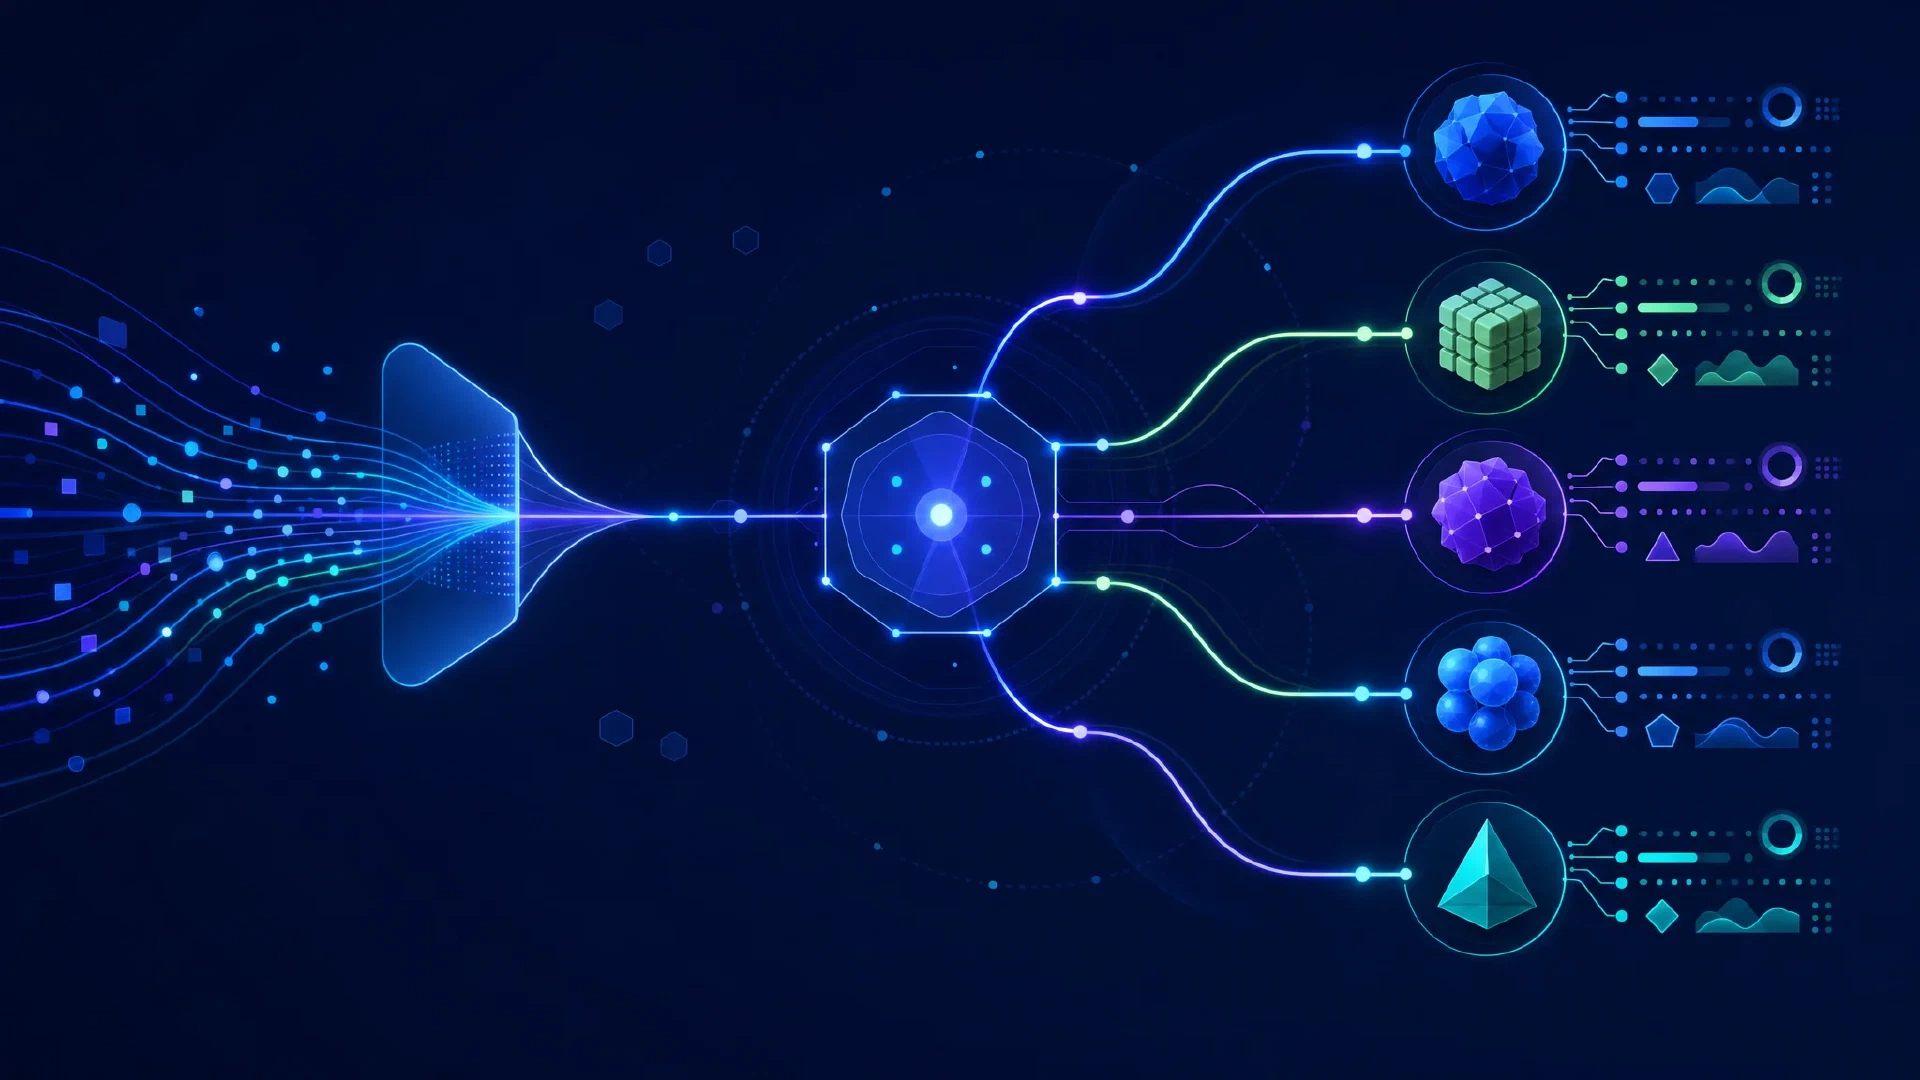
Table of Contents
Provider-routing in OpenRouter bepaalt welke inferentiedienst je verzoek beantwoordt. Twee aanroepen met dezelfde modelnaam hangen nog steeds af van endpointlimieten, ondersteunde parameters, servingsoftware en routeringsvoorkeuren. Worden antwoorden korter of mislukken toolaanroepen, controleer dan deze verschillen voordat je kwantisatie de schuld geeft.
Belangrijkste punten
- Precisielabels beschrijven een numeriek formaat, geen nauwkeurigheidsscore.
- Endpointlimieten bepalen beschikbare context, uitvoerlengte en functieondersteuning.
- Expliciete routing heeft naast een provider voorkeur ook een fallbackbeleid nodig.
- Auto Exacto verbetert de providerselectie met kwaliteitssignalen en biedt een opt-in-route voor verzoeken zonder tools.
- Werkelijke kosten omvatten output, cachegedrag, nieuwe pogingen en geslaagde taakafronding.
Vereisten: kennis van JSON-verzoeken en toegang tot de OpenRouter-configuratie van je toepassing. Endpointinspectie gebruikt een publieke API. Modelverzoeken versturen vereist een API-sleutel en brengt gebruikskosten met zich mee. Controleer endpointmetadata opnieuw voordat je een gedateerd voorbeeld herhaalt.
Tijd en moeilijkheid: ongeveer 20 minuten voor een eerste configuratiecontrole. Gemiddeld niveau. Een bruikbare vergelijking tussen providers vereist extra tests met representatieve prompts.
Wat je modelnaam niet vermeldt
Een model-ID selecteert het gevraagde model. De provider draait de inferentiedienst, inclusief modelimplementatie, tokenlimieten en parser voor toolaanroepen. Een benchmark op modelniveau valideert niet elke dienst die deze gewichten host.
| Endpointeigenschap | Wat je controleert |
|---|---|
| Contextlengte | Ruimte voor prompt, geschiedenis, toolresultaten en generatie |
| Maximale completionlengte | Outputlimiet voor de gevraagde taak |
| Ondersteunde parameters | Tools, gestructureerde output, sampling en redeneerinstellingen |
| Kwantisatie | Gemeld formaat vergeleken met de oorspronkelijke release |
| Prijs | Invoer, uitvoer, cachelezingen en toepasselijke extra kosten |
| Servinggedrag | Completionkwaliteit, parsefouten, latentie en nieuwe pogingen |
Basisrouting geeft gezonde kandidaten met lagere prijzen de voorkeur. OpenRouter beschrijft een omgekeerd kwadratische prijsweging. In het vereenvoudigde voorbeeld krijgt een kandidaat van 1 dollar negen keer het selectiegewicht van een kandidaat van 3 dollar. Dit zijn relatieve gewichten, geen garantie voor je volgende verzoek. Expliciete volgorde, sortering, caching en kwaliteitsrouting beïnvloeden de selectie ook. Bekijk de documentatie over provider-routing .
Prijsweging bewijst niet dat jouw werklast de laagste rekening oplevert. Het gedocumenteerde voorbeeld legt geen universele verhouding tussen invoer en uitvoer vast voor de prijsschaal. Leid de selectiekans van een provider niet af uit alleen de invoerprijs.
Precisie in context lezen
Kwantisatie slaat numerieke waarden op met een kleinere representatie. Het effect hangt af van model, methode en inferentie-implementatie. Lagere precisie vraagt om tests, maar het label alleen bewijst niet dat een provider de oorspronkelijke gewichten heeft gewijzigd.
GPT-OSS geeft een concreet voorbeeld. De release-documentatie van OpenAI voor gpt-oss-120b vermeldt MXFP4 voor de mixture-of-experts-gewichten en dezelfde kwantisatie voor de evaluaties. Een vier-bitslabel voor deze gewichten past bij de gepubliceerde release. Het bewijst geen extra verslechtering door een provider.
Upcasting zet opgeslagen waarden om naar een bredere representatie. Een al gekwantiseerd checkpoint naar BF16 omzetten herstelt geen informatie die tijdens kwantisatie is verwijderd. Een oorspronkelijk checkpoint met hogere precisie naar vier bits omzetten is een aparte wijziging die je moet beoordelen.
| Waarneming | Ondersteunde conclusie |
|---|---|
| Native MXFP4-checkpoint | Vier-bits expertgewichten horen bij de release |
| BF16-endpointlabel | Breder gemeld formaat, zonder bewijs voor betere antwoorden |
| Onbekende precisie | Ontbrekende metadata, zonder bewijs voor verborgen verslechtering |
| Gelijke precisielabels | Onvoldoende bewijs voor gelijkwaardig servinggedrag |
Gelijke labels sluiten verschillen in kwantisatie ook niet uit. Ze vermelden niet welke tensors zijn gekwantiseerd, welke kalibratie is gebruikt of welke uitvoeringskernels draaien. Test het volledige endpoint in plaats van bitdiepte als kwaliteitsranglijst te behandelen.
Het tokenbudget controleren
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
De endpoints-API toont providermetadata voor één model. Dit commando heeft curl en jq nodig. Bekijk de
actuele gpt-oss-120b-endpointrespons
voordat je een dienst kiest. Behandel ontbrekende of null-velden als onbekend, niet als onbeperkt. Bewaar een lokale snapshot met datum wanneer je resultaten vergelijkt.
Een controle op 5 oktober 2026 gaf deze geadverteerde limieten voor gpt-oss-120b terug. Dit zijn metadatawaarden, geen gemeten completionlengtes, en providers wijzigen ze in de tijd.
| Provider | Contexttokens | Maximale completiontokens |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
Contextlengte en uitvoerlengte zijn afzonderlijke limieten. Een model met lange context heeft nog steeds genoeg ruimte voor het antwoord nodig. Gespreksgeschiedenis, systeeminstructies en tooldefinities gebruiken samen met het gebruikersdocument ruimte.
Redeneertokens gebruiken ook generatiebudget bij modellen die ze ondersteunen. Een klein budget geeft risico op onvolledig redeneren, weinig zichtbare output of beëindiging vóór het eindantwoord. Controleer gebruik en finish reason in plaats van aan te nemen dat elk kort antwoord zwakkere gewichten betekent. OpenRouter legt dit budget uit in de documentatie over redeneertokens .
Een expliciete max_tokens geeft de router een gewenste uitvoerlengte om met providerondersteuning te vergelijken. Kies deze op basis van gemeten taakbehoeften en beschikbare context. Een buitensporige waarde beperkt de geschiktheid en garandeert geen langer of beter antwoord.
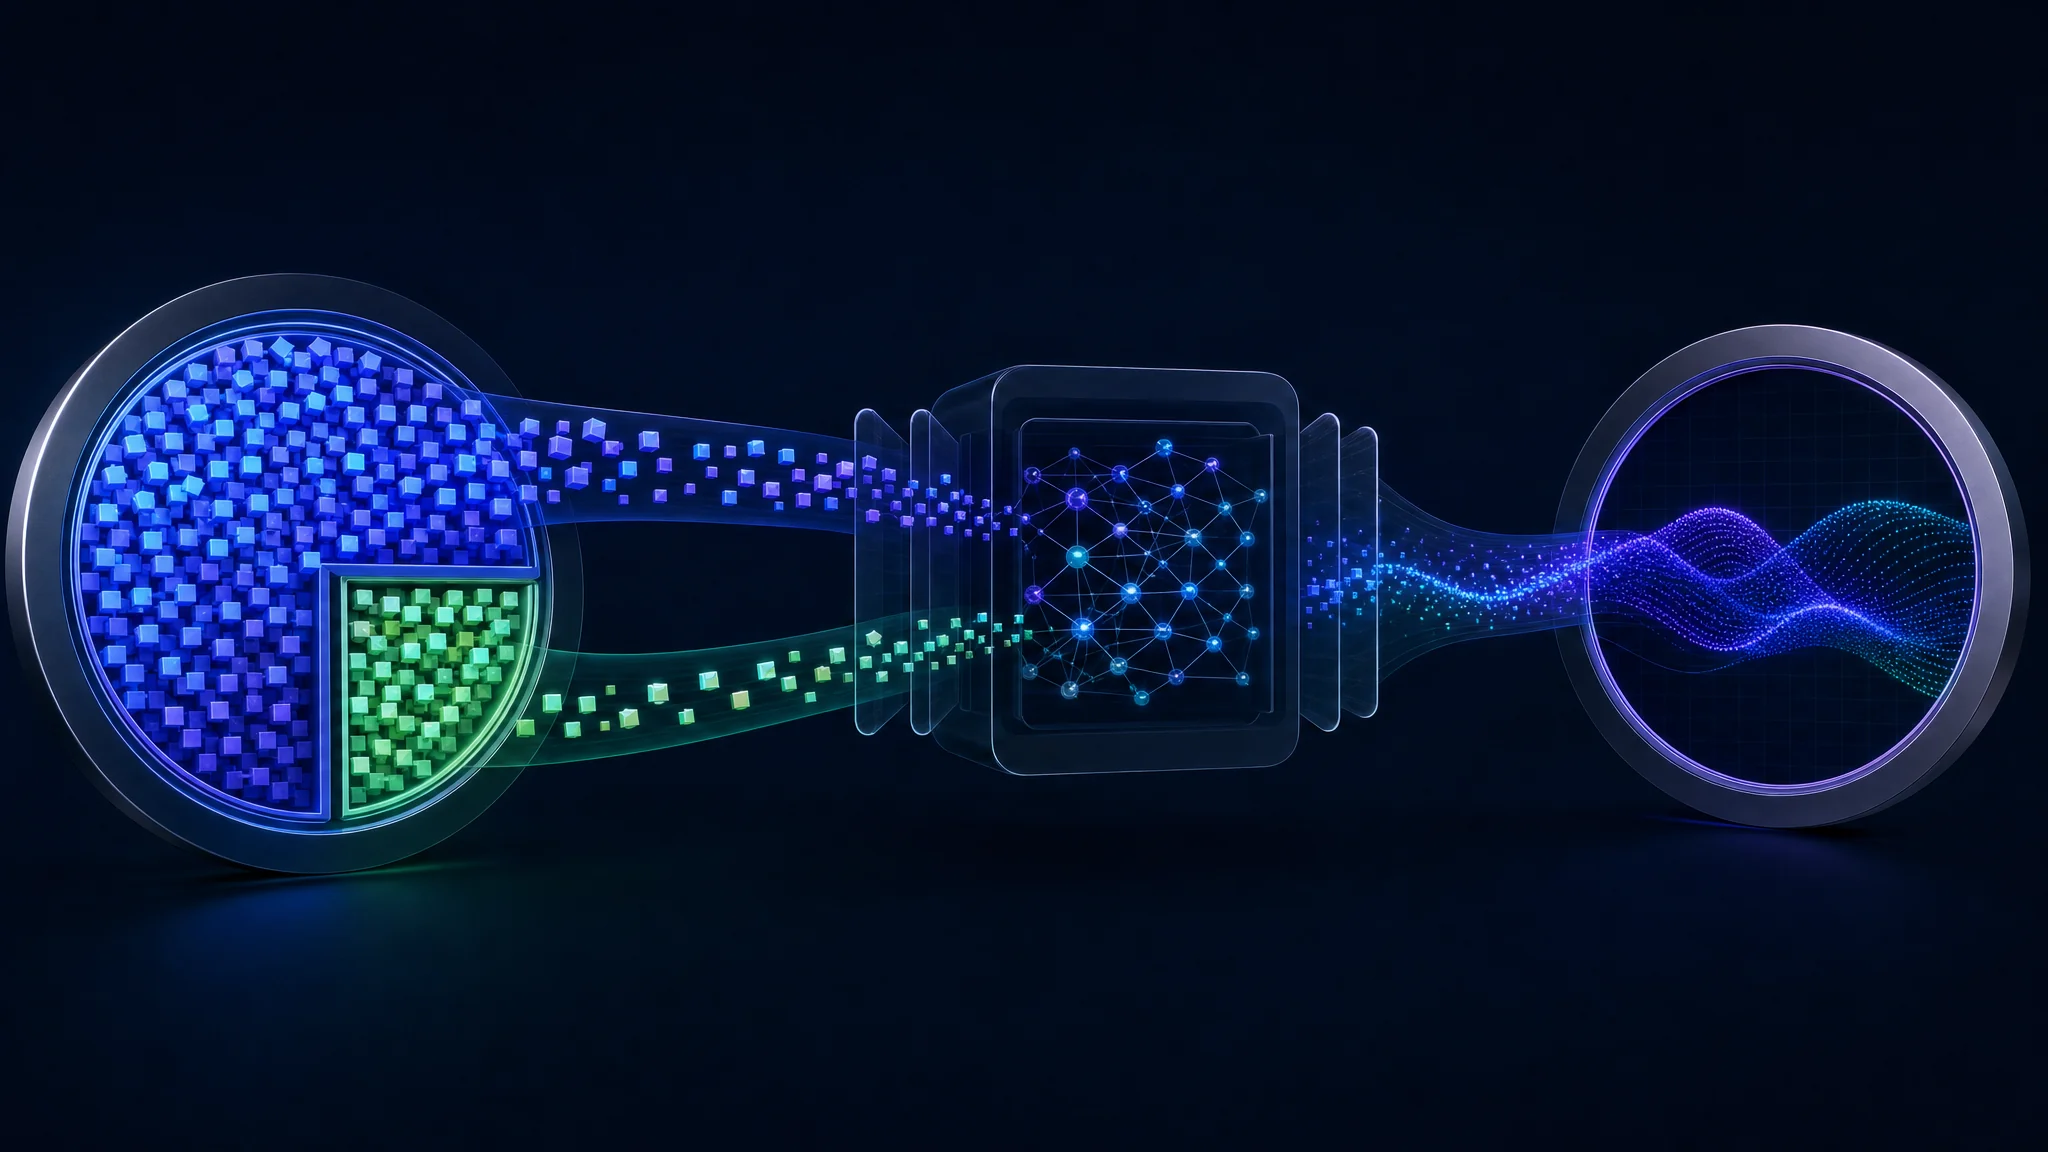
Conceptuele tokenverdeling, waarbij redeneren en zichtbare output het completionbudget delen bij ondersteunde providers
Je parameters verplichten
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters is standaard false. Bij standaardrouting sluiten niet-ondersteunde parameters een endpoint niet altijd uit. OpenRouter beschrijft dat providers onbekende parameters negeren. Zet dit veld op true om routing te filteren op basis van verklaarde ondersteuning.
Ondersteuningsmetadata garandeert geen gedrag. Een endpoint dat seed-ondersteuning adverteert, heeft nog steeds reproduceerbaarheidstests nodig. Een toolgeschikt endpoint heeft schemavalidatie en tests op toepassingsniveau nodig. Het filter voorkomt dat bekende incompatibiliteiten in de kandidatenset komen.
Providers bewust vastzetten
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Vervang de placeholder door een providerslug uit de providerlijst van het model. Stuur het rapport mee in je echte verzoek. Dit sjabloon is bedoeld voor configuratiecontrole. Het is pas uitvoerbaar nadat je de placeholder hebt vervangen.
order stelt een voorkeur in. Op zichzelf laat het fallback naar andere providers actief. In combinatie met allow_fallbacks: false beperkt het routing tot de genoemde providers. Het verzoek mislukt wanneer geen provider het verzoek ondersteunt of beschikbaar blijft.
Endpointvarianten vragen aandacht. Een basis-providerslug past volgens de gedocumenteerde matchregels bij meerdere varianten. Gebruik de specifieke variantslug wanneer je een bepaalde serviceconfiguratie test. Controleer de gerapporteerde provider voor elke respons opnieuw.
quantizations is een allowlist met benoemde formaten, geen numerieke ondergrens. Een array met "fp8" selecteert overeenkomende FP8-endpoints. BF16 of alle formaten met meer bits worden niet automatisch toegevoegd. Vergelijk eerst het oorspronkelijke checkpoint en gebruik deze filter alleen als je evaluatie de beperking ondersteunt.
Kwaliteitsrouting ingeschakeld houden
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto gebruikt throughput, tool-calltelemetrie en benchmarks om minder presterende providers lager te prioriteren. De aankondiging van OpenRouter uit maart 2026 meldt 88% minder tool-call-fouten voor GLM-5, van ongeveer 8% naar ongeveer 1%. Voor gpt-oss-120b meldt de aankondiging een daling van 5,6% naar 3,5%.
Dit zijn door de provider gemelde uitrolresultaten, geen belofte voor jouw toepassing. Geldigheid van toolaanroepen meet JSON, namen en schema’s. Een syntactisch geldige aanroep heeft nog steeds de juiste argumenten en actie voor de taak nodig.
Verzoeken met tools krijgen standaard Auto Exacto wanneer het model voldoende providerdekking heeft. Voor andere verzoeken schakelt :exacto kwaliteitsrouting in. De huidige documentatie ondersteunt kwaliteitsrouting dus voor samenvattingen en chat, naast toolgebruik.
sort: "price", het suffix :floor en een accountbrede standaardprijs-sortering schakelen Auto Exacto uit. Controleer applicatie-instellingen en accountvoorkeuren samen. Raadpleeg de
Auto Exacto-documentatie
voordat je routeringsopties combineert.
De kosten van je werklast berekenen
Alleen de invoerprijs geeft een onvolledige vergelijking. Gebruik deze illustratieve tarieven in dollars per miljoen tokens. Ze tonen de berekening en zijn geen actuele providerquotes.
| Illustratief endpoint | Invoerprijs | Uitvoerprijs |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
Endpoint A kost voor deze mix ongeveer 4,2 keer zoveel ondanks de lagere invoerprijs. De verhouding van 533 tegen 1 tussen A’s uitvoer- en invoerprijs vergelijkt twee tarieven. Het is geen vermenigvuldigingsfactor voor de totale gebruikerskosten. Andere verhoudingen tussen invoer en uitvoer wijzigen de vergelijking.
De prijseenheden van de API verschillen van de vergelijkingstabellen. De endpoint-API geeft tokenprijzen per token. Vermenigvuldig ze met één miljoen voordat je ze vergelijkt met de bovenstaande tarieven.
Promptcaching voegt een variabele toe. Cachelezingen, cachewrites en niet-gecachete invoer vereisen aparte boekhouding volgens de factureringsregels van de provider. Herhaalde tekst garandeert geen cachehit. Controleer gemelde aantallen en kosten van gecachte tokens met de documentatie over promptcaching .
Routing beïnvloedt cachecontinuïteit. OpenRouter beschrijft sticky routing voor caching, terwijl handmatige providerorde voorrang heeft. Auto Exacto herschikt providers en onderbreekt soms een warme cache. Vergelijk gemeten cachebesparingen met kwaliteits- en retrykosten voordat je een van beide beleidsregels wijzigt.
Kosten per geaccepteerd resultaat is de bruikbare toepassingsmaatstaf. Deel alle uitgaven, inclusief retries en mislukte pogingen, door resultaten die aan je acceptatiecriteria voldoen. Neem toepasselijke kosten buiten tokens apart op. Een lage tokenprijs compenseert geen herhaaldelijk mislukte taken.
Een inconsistent antwoord diagnosticeren
| Symptoom | Eerste controle |
|---|---|
| Kort of onvoltooid antwoord | Finish reason, outputbudget, redeneergebruik |
| Ontbrekende documentdetails | Verzonden inhoud, endpointcontextlimiet, truncatie van de client |
| Misvormde toolaanroep | Geadverteerde ondersteuning, toolschema, parsegedrag |
| Ander samplinggedrag | Gevraagde parameters en verklaarde ondersteuning |
| Onverwachte kosten | Outputvolume, cachelezingen, retries, providerwijzigingen |
| Geen geschikte provider | Conflicterende limieten, allowlists en fallbackbeperkingen |
Bewaar de generation-ID die met de respons terugkomt. De generation-metadata-API van OpenRouter toont provideridentiteit, gebruik, kosten en finishinformatie. Een sessie-ID groepeert verwant werk, maar vervangt de generation-ID niet voor één verzoek.
Bewaar het verzoek samen met de generation-ID. Houd model, providervoorkeuren, gevraagde parameters, tijdstip en responsgebruik bij elkaar. Zo blijft een latere kwaliteits- of kostenvergelijking reproduceerbaar wanneer routing, prijzen of endpointmetadata veranderen.
Vergelijk endpoints onder gelijke omstandigheden. Gebruik dezelfde prompt, tools, redeneerinstellingen en tokenlimiet. Herhaal de test met verschillende representatieve taken. Houd onvolledige antwoorden, ongeldige toolaanroepen en foute antwoorden apart in plaats van ze samen te voegen tot een onverklaarde kwaliteitsscore.
Onzekerheid in benchmarks is relevant. Epoch AI’s analyse van benchmarking beschrijft variatie door implementaties, sampling en agent-scaffolds. Eén teleurstellend antwoord bewijst geen blijvend providerprobleem en legt de oorzaak niet vast.
Rondleiding door endpoint-routing
Meer informatie: Bespreking van OpenRouter-endpointkwaliteit en routing . Controleer endpointlijsten opnieuw voordat je specifieke prijzen, limieten of providervergelijkingen toepast.
Volgende stappen
- Inspecteer de endpoints van één model en noteer limieten die bij je werklast passen.
- Kies een routingbeleid met expliciete parametervereisten en fallbackgedrag.
- Test representatieve taken tegen kandidaat-endpoints en kwaliteitsrouting.
- Registreer kosten per geaccepteerd resultaat samen met latentie, cachegebruik en foutcategorieën.
- Controleer opnieuw na wijzigingen in modelversies, servinggedrag of providerprijzen.
Voor bredere AI-basiskennis ga je verder met Basisbegrippen van AI . Voor agentmachtigingen en validatiecontroles lees je AI-systemen beveiligen .
Related Posts