Lokale AI-programmering op een 16GB-GPU: Strata, OpenCode en Qwen3.8
Table of Contents
Een lokale codeeragent op een 16GB-GPU is praktisch voor afgebakende ontwikkeltaken. Strata en OpenCode combineren lokale inferentie met bestandsbewerking, shellopdrachten en testuitvoering. Een gemelde Qwen3.8-Flash-Next-run op een RTX 4060 Ti voltooide een toepassing, vervolgaanpassingen en een prototype van een racegame zonder betaalde inferentie-aanroepen.
Een abonnement vervangen vereist een bredere test. De gepubliceerde resultaten tonen een werkende opstelling op één machine. Ze bewijzen geen gelijkwaardigheid met betaalde codeerdiensten voor verschillende talen, repositories of moeilijke debugtaken. De hardware bevat ook 64GB systeemgeheugen, dat een groot deel van het model draagt.
Belangrijkste punten
- 16GB beschrijft GPU-geheugen, niet het totale geheugen dat de gemelde configuratie nodig heeft.
- Prompthergebruik is belangrijk, omdat codeeragenten herhaaldelijk overlappende conversatiegeschiedenis versturen.
- Redeneren heeft een budget nodig, zodat planning ruimte laat voor code en toolaanroepen.
- Geslaagde gegenereerde tests zijn gedeeltelijk bewijs, terwijl Docker en gameplay aparte controles vereisen.
- Nul API-uitgaven sluiten eigendomskosten uit, zoals elektriciteit en onderhoudstijd.
Vereisten: Een compatibele computer, genoeg vrije opslag voor het gekozen model, Git, Node.js met npm en ervaring met terminaltools. Combineer de gemelde IQ3_S-opstelling met 64GB RAM. Gebruik het huidige Strata-installatieprogramma om andere configuraties te controleren.
Tijd en moeilijkheid: Gemiddeld. Reserveer tijd voor grote modeldownloads en installatie voordat je de snelheid van taakvoltooiing beoordeelt. De gemelde taakduur is exclusief de installatie.
Geteste configuratie
| Component | Gemelde configuratie |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16GB VRAM |
| CPU | Intel Core i5-11600K |
| Systeemgeheugen | 64GB RAM |
| Opslag | NVMe-SSD |
| Model | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Inferentie-engine | Strata |
| Codeeragent | OpenCode |
| Geconfigureerde context | 65.536 tokens |
| Geconfigureerde uitvoerlimiet | 16.384 tokens |
De door NetworkCoder gepubliceerde configuratie en resultaten leveren deze cijfers. De testrepository meldt dat 46.84GiB expertgewichten in 28 seconden werd geladen, waarbij 4.431 experts 8.45GiB GPU-geheugen gebruikten. Deze metingen beschrijven de geteste run, niet een gegarandeerde toewijzing met een andere engineversie.
De huidige compatibiliteit is breder dan deze test. Het Strata-project , gecontroleerd op 6 oktober 2026, documenteert geselecteerde NVIDIA- en AMD-kaarten met minstens 12GB VRAM en kleinere modellen voor systemen met 32GB RAM. Deze opties reproduceren het experiment met een 16GB-GPU, 64GB RAM en IQ3_S niet. Controleer de exacte GPU, modelvariant en runtimeondersteuning voordat je hardware koopt.
Waar het model staat
Mixture of experts, of MoE, activeert voor elke token een deel van de expertnetwerken van een model. Dit verlaagt de actieve berekening vergeleken met het gebruik van alle parameters bij elke stap. De overige gewichten hebben nog steeds opslag en een route naar de berekening nodig.
Strata’s hybride uitvoering houdt vaak gebruikte experts op de GPU en bewaart de expertverzameling in systeem-RAM. De CPU berekent niet-gecachete experts ter plaatse, terwijl de GPU gecachte experts verwerkt. Opslag bevat ook modelbestanden en opzoekgegevens. Het systeem stopt het volledige 125B-model niet in 16GB VRAM.
GPU-geheugen heeft concurrerende toepassingen. Runtime-toewijzingen, attentionstatus en expertcache delen een beperkte bron. Meer ruimte voor context verandert de resterende capaciteit van de expertcache. Huidige Strata-versies ondersteunen ook KV-cache-streaming, waardoor de exacte plaatsing verschilt van een oudere configuratie. Raadpleeg de technische documentatie voor jouw engineversie.
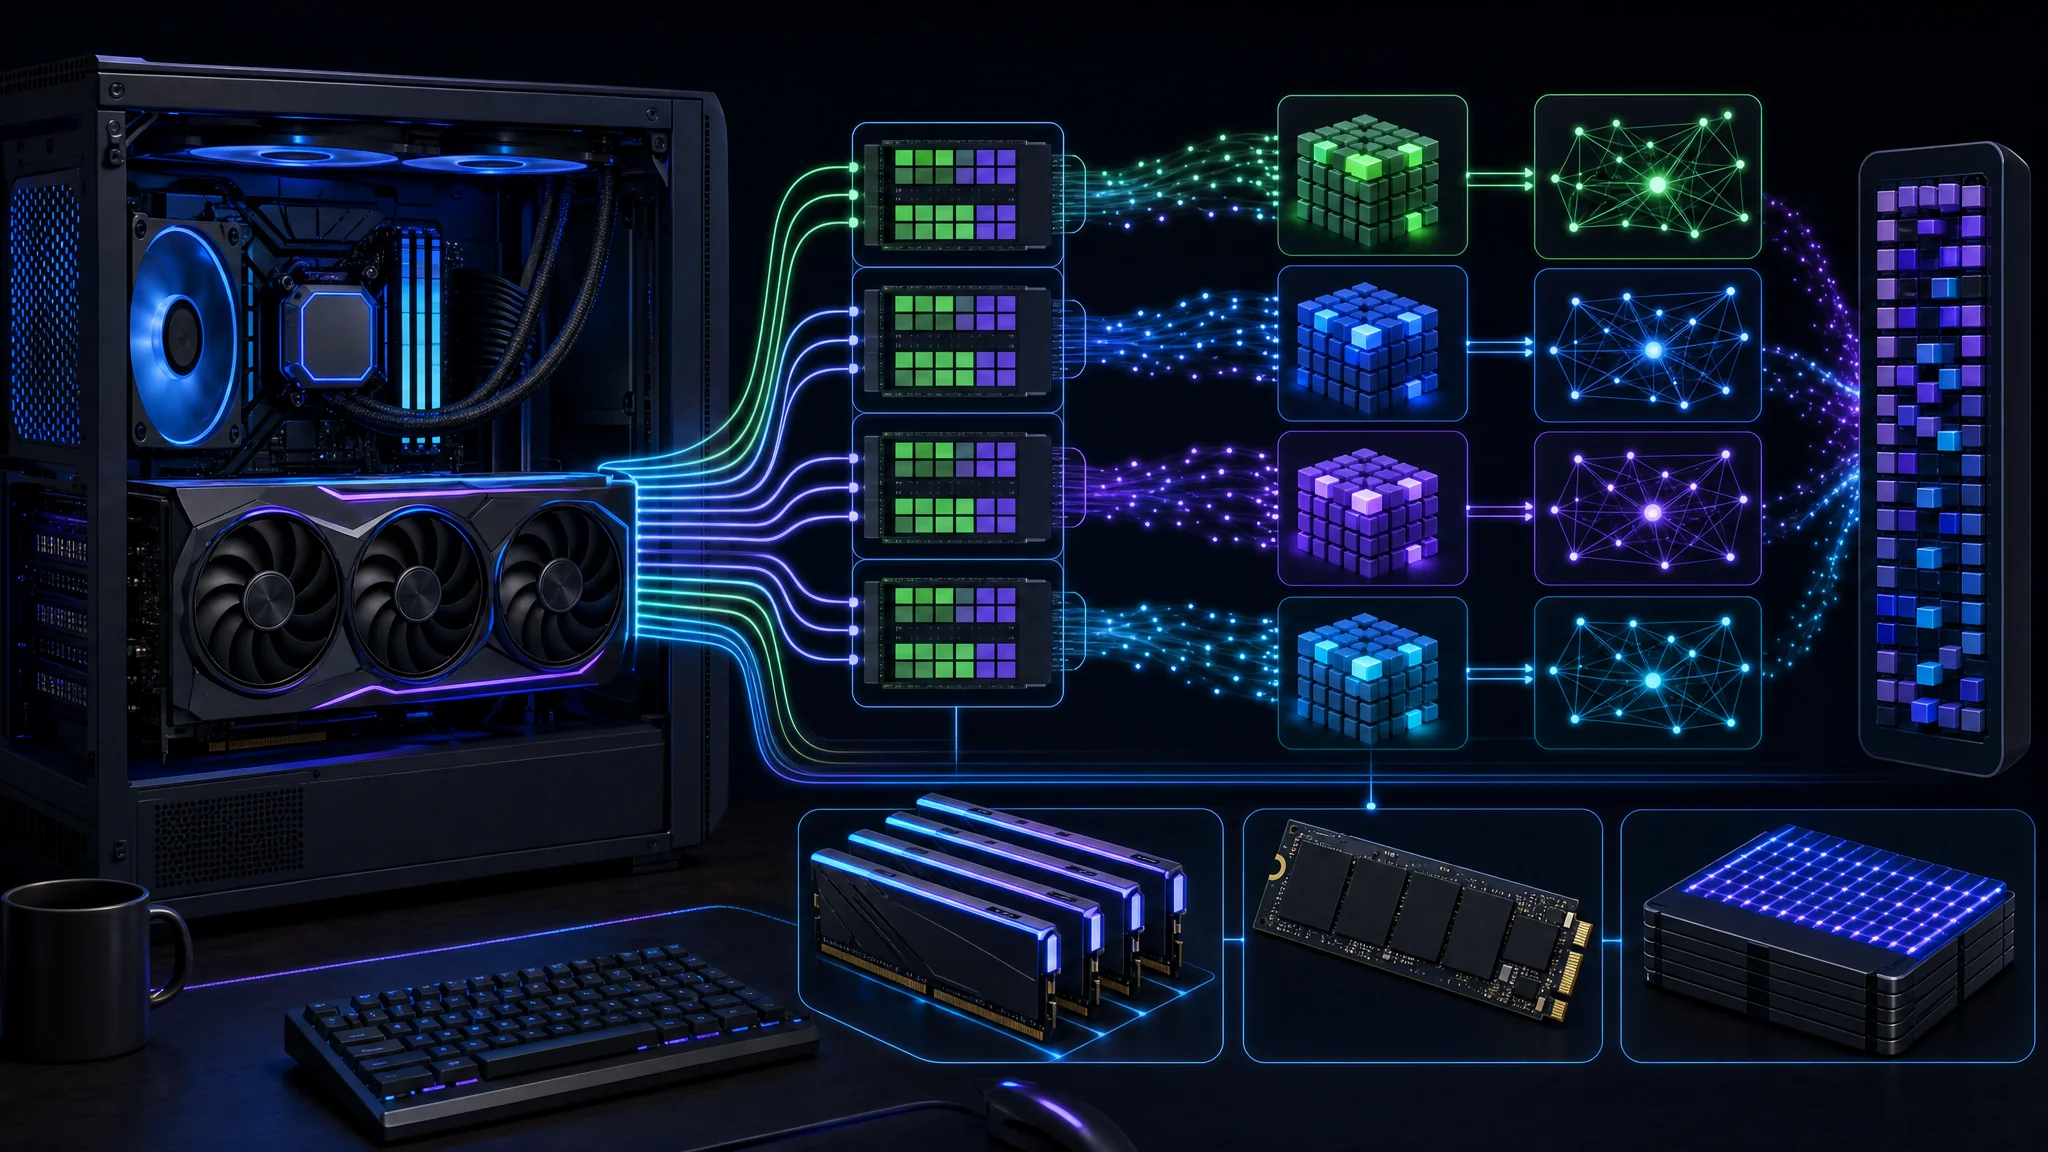
The GPU is one part of the inference system, alongside CPU execution, system RAM, and storage
Prompthergebruik verandert de snelheid
Een codeeragent werkt in een lus: lees de taak, vraag een toolactie, ontvang het resultaat en bepaal de volgende actie. Bestandsinhoud, fouten en testuitvoer stapelen zich op in de conversatie. Agents comprimeren of selecteren ook context, waardoor niet elke implementatie voor altijd een ongewijzigde volledige geschiedenis opnieuw verstuurt.
Prefill verwerkt invoertokens vóór generatie. Decode produceert het antwoord. Een systeem met snelle decode maar trage herhaalde prefill laat je tussen toolaanroepen wachten.
De gemelde timing voor 44K tokens gebruikte prefixhergebruik. Strata hergebruikte eerder verwerkte conversatie-inhoud en had de groeiende prompt in ongeveer één tot drie seconden klaar. Dit is nuttig bewijs voor een doorlopende agentsessie. Het bewijst niet dat 44.000 volledig nieuwe tokens vanaf nul in één seconde werden verwerkt.
| Meting | Wat je moet vastleggen |
|---|---|
| Koude prompt | Tijd voor nieuwe inhoud zonder herbruikbare prefixstatus |
| Warme voortzetting | Tijd nadat een toolresultaat aan bestaande context is toegevoegd |
| Generatiesnelheid | Tokens per seconde tijdens het antwoord |
| Taakduur | Planning, generatie, tools, tests en nieuwe pogingen samen |
Twee caches hebben verschillende doelen. De expertcache houdt vaak gebruikte gewichten dicht bij de GPU-berekening. Prefixhergebruik voorkomt herhaald werk op eerdere invoer. Een hoog hitpercentage van de expertcache bewijst geen hit in de promptcache.
Wat de taken lieten zien
| Taak | Gemelde tijd | Gemeld resultaat |
|---|---|---|
| Taakbeheerder bouwen | 3m 38s | Express-API, interface, 5/5 tests |
| Bewerken herstellen en datums toevoegen | 4m 58s | Wijzigingen voltooid, 6/6 tests |
| Export/import en packaging toevoegen | 3m 48s | 7/7 tests, Docker-build niet geverifieerd |
| Racegame, eerste poging | 6m 35s | Uitvoer tijdens redeneren opgebruikt, geen code |
| Racegame, poging met budget | 4m 51s | Game gegenereerd, JavaScript-syntaxis gecontroleerd |
Het gepubliceerde resultatenbestand rapporteert uitvoersnelheden van 48 tot 52 tokens per seconde voor de eerste taak, 40 tot 43 voor de tweede en 37 tot 44 voor de derde. “Tot 52” is een piek in deze waarnemingen, geen volgehouden snelheid voor elke taak.
De eerste drie taken breiden één toepassing uit. De aantallen 5/5, 6/6 en 7/7 beschrijven opeenvolgende testsuites. Ze optellen bewijst geen 18 onafhankelijke mogelijkheden. Ook tests die door dezelfde agent zijn geschreven moeten worden beoordeeld op dekking en zinvolle assertions.
Omgevingsherstel hoorde bij het werk. De agent herstelde van een ongeschikte shellopdracht en vond tijdens het testen een verouderde applicatieserver. Dit gedrag is nuttig, maar een bestaand proces beëindigen vereist bewuste toestemming in een gedeelde ontwikkelomgeving.
Docker bleef niet geverifieerd. De agent schreef een Dockerfile maar had geen draaiende Docker-engine voor de build. Geslaagde applicatietests buiten de container bewijzen geen werkende image. De gamepoging controleerde de syntaxis en opende een browser, maar de agent had geen directe visuele bevestiging van de gameplay.
Reserveer ruimte voor uitvoer
{
  "reasoning_budget_tokens": 8000
}
Voeg deze instelling samen met de bestaande configuratie strata-iq3_s.json, behoud de overige velden en start het geselecteerde Strata-model opnieuw. Dit is een Strata-instelling, geen vervanging van het OpenCode-configuratiebestand. Controleer het actieve budget in de opstartuitvoer.
Strata documenteert een hard redeneerbudget dat de denkfase beëindigt en naar een antwoord overgaat. Een waarde op verzoekniveau overschrijft de geconfigureerde standaard. Deze instelling verschilt van een algemene instructie voor redeneerinspanning zoals low of high.
De eerste gamepoging gebruikte de toelating van 16.384 tokens tijdens de planning volledig op. De nieuwe poging gebruikte een denkbudget van 8.000 tokens en leverde code. Dit ondersteunt een begrensde redeneerfase voor deze werklast. Het bewijst niet dat 8.000 de beste instelling voor elke taak is.
De resterende uitvoerruimte is een maximum, geen reserveringsgarantie. Als een limiet van 8.000 tokens volledig wordt verbruikt binnen een totale limiet van 16.384, blijven vóór overige overhead ongeveer 8.384 tokens over. Het resultatenlog meldt 11.054 geschreven tokens voor de nieuwe poging, zonder volledige verdeling tussen redeneren en code. Interpreteer dit niet als 8.000 redeneertekens plus 11.054 codetekens binnen dezelfde limiet.
Gebruik een kleiner budget voor kleine wijzigingen, en test grotere budgetten voor taken die meer analyse vragen. Bekijk de volledige bestandsuitvoer, voltooiingsstatus en testresultaten. Meer plantijd helpt alleen wanneer de geleverde wijziging verbetert.
Strata en OpenCode verbinden
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Dit is het Linux-installatiepunt. Bekijk de huidige installatie-instructies en gebruik START-HERE.bat voor het gedocumenteerde Windows-pad. Selecteer de oorspronkelijke Qwen3.8-Flash-Next IQ3_S-variant en een context van 65.536 tokens om de gemelde configuratie te benaderen. Bewaar de engineversie en modelbestanden bij je benchmarknotities.
npm install -g opencode-ai
Installeer OpenCode met de
officiële instructies
. Stel in een aparte terminal STRATA_BASE_URL in op de lokale API-basis die Strata toont, inclusief het suffix /v1. Houd inferentie voor deze opstelling aan de lokale machine gebonden.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Voeg het providerblok samen in ~/.config/opencode/opencode.json, en behoud bestaande instellingen. Dit past het
gepubliceerde configuratievoorbeeld
aan door het lokale eindpunt uit een omgevingsvariabele te laden. OpenCode documenteert
aangepaste providers
en
omgevingssubstitutie
.
local is een plaatsvervangende referentie, passend bij het voorbeeld van een lokale installatie zonder authenticatie. Het beveiligt geen server. Als je Strata-instantie authenticatie gebruikt, geef dan de geconfigureerde referentie door via het passende lokale geheimenmechanisme.
Start opencode in een wegwerpkopie van een project en selecteer het geconfigureerde model. Controleer de geselecteerde provider voordat je code verstuurt. De contextverklaring aan clientzijde vergroot de servercontext niet, en een venster van 65.536 tokens laat geen 65.536 tokens voor invoer over wanneer ook uitvoerruimte nodig is.
Lokale inferentie en machtigingen
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Voeg deze initiële machtigingen samen met de OpenCode-configuratie tijdens het beoordelen van de agent. De documentatie over machtigingen beschrijft de beschikbare controles. Bestandswijzigingen en shelluitvoering beïnvloeden je machine, ongeacht waar inferentie draait.
Lokale inferentie maakt niet elk hulpmiddel lokaal. Pakketdownloads, webtools, externe integraties en optioneel delen gebruiken nog steeds netwerkdiensten. Bekijk actieve tools voordat je privérepositories verwerkt. “Het model draait lokaal” is een smallere claim dan “niets verlaat de computer”.
Problemen oplossen bij de eerste run
| Symptoom | Controleer eerst |
|---|---|
| Provider niet beschikbaar | Strata draait en de omgevingsvariabele bereikt het OpenCode-proces |
| Model ontbreekt in selectie | Provider-ID en model-ID komen overeen met de opgeslagen configuratie |
| Contextlimietfout | Promptlengte plus gevraagde uitvoer past in het actieve servervenster |
| Planning zonder code | Redeneerbudget, totale uitvoerlimiet en voltooiingsstatus |
| Trage voortzetting | Prefixhergebruik, geheugendruk, gedrag van expertcache en concurrerende processen |
| Dockeropdracht mislukt | Er is een werkende engine beschikbaar, niet alleen een opdrachtregelclient |
Wijzig één instelling tegelijk en herhaal dezelfde taak vanuit een opgeslagen starttoestand. Zo houd je een configuratieverbetering gescheiden van een andere prompt of een eenvoudigere test.
Vervangt dit een abonnement?
| Lokale opstelling verdient een test | Houd een andere optie beschikbaar |
|---|---|
| Bestaande compatibele hardware | Hardware kopen voor een ongeteste werklast |
| Afgebakende toepassingswijzigingen | Grote onbekende repositories en moeilijke migraties |
| Herhaalbare acceptatietests | Taken zonder betrouwbare manier om correctheid te controleren |
| Tijd voor runtimeonderhoud | Werk dat weinig installatie en ondersteuning vraagt |
Nul API-uitgaven zijn relevant, vooral wanneer hardware al beschikbaar is. Elektriciteit, hardwareafschrijving, opslag en tijd voor omgevingsonderhoud vallen erbuiten. Het weergegeven kostenveld van nul meet deze uitgaven evenmin.
Een abonnementsvergelijking vereist gelijke taken. Gebruik in beide systemen dezelfde startrepository, instructies en acceptatiecontroles. Noteer nieuwe pogingen en menselijke correcties naast de verstreken tijd. Neem de mislukte eerste gamepoging mee in de volledige workflow, en rapporteer niet alleen de geslaagde herhaling.
Een bruikbare lokale agent hoeft niet overal beter te zijn. Als hij je gewone wijzigingen betrouwbaar afhandelt en een kleine groep moeilijke taken aan een andere tool overlaat, verandert hij al welke betaalde diensten je nodig hebt. Beslis op basis van geaccepteerd werk in je eigen projecten.
Demonstratie en volgende stappen
Bekijk ook: De demonstratie van de 125B lokale codeeragent . De hierboven gemelde metingen horen bij de gepubliceerde test, niet bij een onafhankelijke benchmark die voor dit artikel is uitgevoerd.
- Reproduceer één kleine taak met vaste acceptatiecriteria en een opgeslagen startrevisie.
- Meet koude en warme beurten in plaats van prefixhergebruik als koude prefill-snelheid te behandelen.
- Controleer packaging afzonderlijk met een geslaagde image-build, opstart en controles op containerniveau.
- Bekijk de gegenereerde tests en voeg gevallen toe waarop de implementatie niet had gerekend.
- Vergelijk voltooid werk met je huidige codetool voordat je abonnementen wijzigt.
Lees voor hardwareplanning de gids voor lokaal AI-model en GPU-context . Bekijk voor gedrag van gehoste modellen providerroutering en kosten bij OpenRouter .
Related Posts